Statistiques descriptives
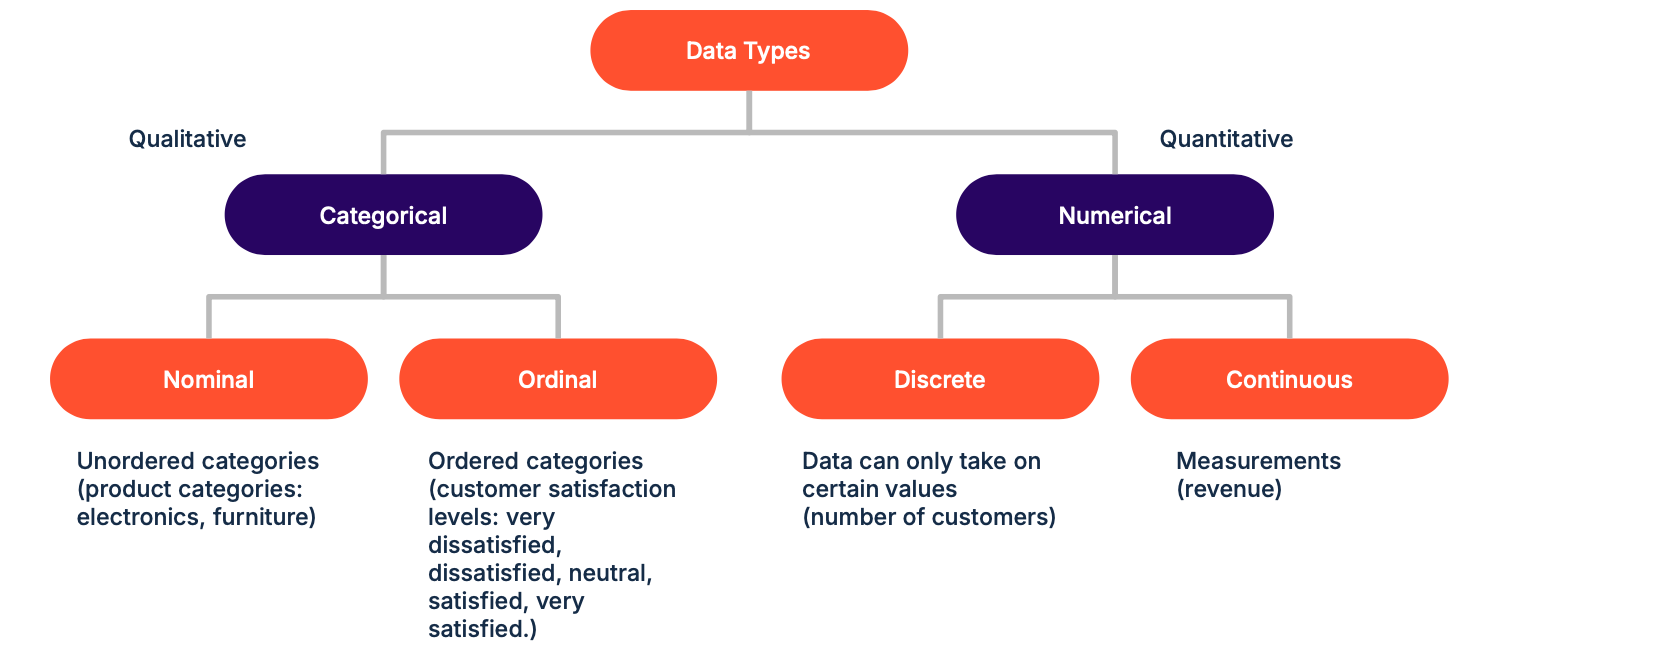
Les données se présentent sous de nombreuses formes, et comprendre leurs types est crucial pour l'analyse et l'interprétation. Les données peuvent être largement catégorisées en données quantitatives et qualitatives.
Données qualitatives : catégorielles
Les données qualitatives décrivent des attributs non numériques. Elles peuvent être décomposées en :
- Données nominales : Représentent des catégories sans ordre spécifique. Par exemple :
- Types de retours clients, comme "Positif", "Neutre" et "Négatif".
- Catégories de produits, comme "Électronique", "Vêtements" et "Mobilier".
- Données ordinales : Représentent des catégories ordonnées où le classement est important. Par exemple :
- Niveaux de satisfaction client, comme "Très Insatisfait", "Insatisfait", "Neutre", "Satisfait" et "Très Satisfait".
- Évaluations de performance des employés, comme "Nécessite des Améliorations", "Répond aux Attentes" et "Dépasse les Attentes".
Données quantitatives : numériques
Les données quantitatives traitent des nombres et des quantités mesurables. Elles sont divisées en :
- Données discrètes : Représentent des valeurs ou événements dénombrables. Par exemple :
- Nombre de clients visitant un magasin quotidiennement.
- Unités vendues d'un produit par semaine.
- Données continues : Représentent des mesures et peuvent prendre n'importe quelle valeur dans une plage. Par exemple :
- Revenus générés au fil du temps (par exemple, mensuels ou annuels).
- Prix des produits qui varient en fonction de l'offre et de la demande.
Lorsque vous analysez un ensemble de données, il est essentiel d’identifier une valeur représentative ou mesure de centralité qui résume au mieux l’ensemble des observations. Cela permet de comprendre rapidement où se situent les tendances principales et d’appuyer vos décisions sur des chiffres clés.
Avant d’explorer des analyses plus avancées, la première étape consiste à examiner la tendance centrale d’une variable (une colonne de données). Trois indicateurs fondamentaux vous aideront à y voir plus clair.
La moyenne arithmétique
La moyenne est la valeur moyenne d'un ensemble de nombres. Elle est calculée en additionnant toutes les valeurs d'un jeu de données et en divisant par le nombre total de valeurs.
Par exemple, considérez ce petit jeu de données :
0, 1, 1, 2, 3, 3, 3, 4, 4
- Additionnez tous les points de données :
- 0 + 1 + 1 + 2 + 3 + 3 + 3 + 4 + 4 = 21
- Divisez la somme par le nombre de points de données :
- Il y a 9 points de données, donc divisez 21 par 9.
- 21 / 9 = 2.33
Un problème majeur est que la moyenne est particulièrement sensible aux valeurs aberrantes - ces valeurs inhabituellement hautes ou basses qui peuvent déformer l'image globale. Par exemple, imaginez que le jeu de données ci-dessus ait un point de données supplémentaire de 100. Cela augmenterait significativement la somme et, par conséquent, la moyenne, rendant la valeur moyenne beaucoup plus élevée que ce que suggèrent la plupart des points de données.
Pandas fournit une fonction intégrée .mean() pour calculer la moyenne des colonnes numériques. Si vous voulez calculer la moyenne d'une colonne spécifique dans un DataFrame, utilisez la fonction .mean() comme ceci :
import pandas as pd

# Sample DataFrame
data = {
    'sales': [200, 150, 400, 300, 250],
    'profits': [20, 15, 40, 30, 25]
}

df = pd.DataFrame(data)

# Calculating the mean of the 'sales' column
mean_sales = df['sales'].mean()
print("Mean Sales:", mean_sales)
# Output
# Mean Sales: 260.0
Pour calculer la moyenne de toutes les colonnes numériques du DataFrame, vous pouvez appeler .mean() sur le DataFrame lui-même :
mean_all = df.mean()
print("Mean for all columns:\n", mean_all)
# Mean for all columns:
# sales      260.0
# profits     26.0
La médiane
Elle représente la "valeur centrale" d'un jeu de données lorsque les nombres sont rangés par ordre croissant ou décroissant. Contrairement à la moyenne, qui est affectée par chaque valeur du jeu de données (particulièrement les valeurs aberrantes), la médiane fournit une meilleure indication du centre dans les cas où il y a des valeurs extrêmes.
Le processus de recherche de la médiane dépend du nombre de points de données pair ou impair :
- Nombre impair d'observations : Quand le jeu de données contient un nombre impair de valeurs, la médiane est simplement le nombre du milieu après avoir trié les données. Par exemple :
- Jeu de données : 3, 1, 4, 2, 5
- Trié : 1, 2, 3, 4, 5
- Médiane : 3 (la troisième valeur dans cette liste ordonnée)
- Nombre pair d'observations : Quand le jeu de données contient un nombre pair de valeurs, la médiane est la moyenne des deux valeurs du milieu. Par exemple :
- Jeu de données : 3, 1, 4, 2, 5, 6
- Trié : 1, 2, 3, 4, 5, 6
- Valeurs du milieu : 3 et 4
- Médiane : (3 + 4) / 2 = 3.5
Pandas fournit une fonction intégrée .median() pour calculer la médiane des colonnes numériques. Si vous voulez calculer la médiane d'une colonne spécifique dans un DataFrame, utilisez la fonction .median() comme ceci :
import pandas as pd

# Sample DataFrame
data = {
    'sales': [200, 150, 400, 300, 250],
    'profits': [20, 15, 40, 30, 25]
}

df = pd.DataFrame(data)

# Calculating the median of the 'sales' column
median_sales = df['sales'].median()
print("Median Sales:", median_sales)
# Output:
# Median Sales: 250.0
Pour trouver la médiane de toutes les colonnes numériques du DataFrame, vous pouvez appeler .median() sur le DataFrame entier :
# Calculating the median for all numerical columns
median_all = df.median()
print("Median for all columns:\n", median_all)
# Output
# Median for all columns:
# sales      250.0
# profits     25.0
Le mode
Identifie la ou les valeur(s) apparaissant le plus fréquemment dans un jeu de données. Contrairement à la moyenne ou à la médiane, qui fournissent des mesures du "centre" des données, le mode se concentre sur l'identification de la ou des valeur(s) qui apparaissent le plus souvent. Le mode peut être utile dans les jeux de données quantitatifs et qualitatifs et est particulièrement utile pour les données catégorielles (par exemple, "couleur préférée", "produit le plus populaire") car la moyenne et la médiane n'ont pas de sens pour les données non numériques.
Pour trouver le mode d'un jeu de données :
- Comptez le nombre d'occurrences de chaque valeur.
- Identifiez la ou les valeur(s) avec le plus grand nombre d'occurrences.
Par exemple, dans ce jeu de données :
- Jeu de données : 1, 2, 2, 3, 4, 4, 4, 5, 5
- La valeur 4 apparaît le plus fréquemment (trois fois), ce qui en fait le mode.
Si le jeu de données était :
- Jeu de données : 1, 1, 2, 2, 3, 4, 5
- Les valeurs 1 et 2 apparaissent toutes deux deux fois, donc le jeu de données est bimodal, avec les modes 1 et 2.
Pandas fournit un moyen simple de calculer le mode en appelant la fonction .mode() sur un DataFrame :
import pandas as pd

# Sample DataFrame
data = {
    'product_ids': [101, 102, 103, 101, 102, 101, 104, 105, 101]
}

df = pd.DataFrame(data)

# Calculating the mode of the 'product_ids' column
mode_product_ids = df['product_ids'].mode()
print("Mode of product_ids:", mode_product_ids[0])

# Output:
# Mode of product_ids: 101
Exercice
Objectif
Dans cet exercice, vous explorerez le jeu de données customers_cleaned.csv en identifiant ses types de données et en calculant les principales mesures de tendance centrale
Setup :
- Créez un Notebook Jupyter nommé
summary_statistics.ipynbdans le dossierexercisesà l'intérieur deSummary_Statistics - Copiez customer_clean.csv dans le dossier
exercises
Statistiques descriptives (tendance centrale) :
- Chargez le fichier
customers_cleaned.csvdans un dataframe df - Identifiez les types de données :
- Examinez les colonnes du jeu de données et classez-les comme étant soit Numériques (continues/discrètes) soit Catégorielles (nominales/ordinales).
- Calculez la tendance centrale pour les colonnes numériques :
- Calculez la moyenne, la médiane et le mode pour chaque colonne numérique
- Sont-ils similaires ?
- Pour chaque colonne catégorielle, calculez le mode et affichez la distribution des fréquences (conseil : utilisez la fonction
.value_counts()sur le DataFrame)
Solution
Voir la solution
Chargez le fichier customers_cleaned.csv
    import pandas as pd

    # Load the CSV file
    file_path = 'customers_cleaned.csv'
    df = pd.read_csv(file_path)

    # Display the first few rows of the dataset
    df.head()

    ```
Voir la solution
Identifiez les types de données
    # Identify data types (done based on inspection)
    # Numerical columns identified: 'age'
    # Categorical columns identified:
    # 'customer_id', 'gender', region_id are nominal columns
    # 'income_level' is ordinal meaning it has a natural order
    # We will proceed only with 'gender' and 'income_level'
    # customer_id is Unique and Non-Informative for Summary Statistics
    # region_id more suitable for group-based operation

    ```
Voir la solution
Calculez la tendance centrale pour les colonnes numériques
# List of numerical columns in the dataset
numerical_columns = ['age']

# Iterate through each numerical column
for col in numerical_columns:
    # Calculate mean, median, and mode
    mean_val = df[col].mean()
    median_val = df[col].median()
    mode_val = df[col].mode()[0]  # Get the first mode if multiple exist

    # Print summary statistics for each column
    print(f"\nSummary Statistics for {col}:")
    print(f"Mean: {mean_val}")
    print(f"Median: {median_val}")
    print(f"Mode: {mode_val}")
    ```
Voir la solution
Calculez le mode et la distribution des fréquences pour les colonnes catégorielles
# Define the categorical columns we want to analyze
categorical_columns = ['gender', 'income_level']

# Iterate through each categorical column
for col in categorical_columns:
    # Calculate the frequency distribution
    unique_counts = df[col].value_counts()
    # Find the mode (most frequent value)
    mode_val = df[col].mode()[0]

    # Print the results
    print(f"\nFrequency and Mode for {col}:")
    print(f"Counts:\n{unique_counts}")
    print(f"Mode: {mode_val}")
    ```
Alors que les mesures de tendance centrale (comme la moyenne, la médiane et le mode) nous aident à comprendre le centre d'un jeu de données, les mesures de dispersion donnent un aperçu de la façon dont les données sont distribuées ou dispersées autour de ce centre. Savoir à quel point les données sont "étalées" aide à comprendre leur variabilité et le degré auquel les valeurs diffèrent les unes des autres et du centre.
L'étendue
C'est la mesure de dispersion la plus simple, calculée comme la différence entre les valeurs maximale et minimale du jeu de données. Elle est utilisée pour avoir une idée rapide de la dispersion, mais il faut être prudent car elle est sensible aux valeurs aberrantes.
Si un jeu de données contient les valeurs 10, 15, 20, 25 et 30, l'étendue est 30 - 10 = 20.
Vous pouvez calculer cette mesure facilement avec Pandas :
import pandas as pd

# Sample DataFrame
data = {
    'values': [10, 15, 20, 25, 30, 35, 40, 45, 50]
}

df = pd.DataFrame(data)

# Calculating measures of spread
range_value = df['values'].max() - df['values'].min()

print("Range:", range_value)

# Output:
# Range: 40
Intervalle interquartile
L'IQR est la différence entre le troisième quartile (Q3) et le premier quartile (Q1) des données. Les quartiles divisent les données en quatre parties égales.
Pour diviser les données en quartiles, vous séparez le jeu de données en quatre parties égales après avoir trié les valeurs. Chaque quartile représente 25% des données, aidant à comprendre leur distribution. Les quartiles sont :
Q1 (Premier quartile ou 25e percentile) : La valeur en dessous de laquelle se trouvent 25% des données.
Q2 (Deuxième quartile ou médiane) : La valeur en dessous de laquelle se trouvent 50% des données.
Q3 (Troisième quartile ou 75e percentile) : La valeur en dessous de laquelle se trouvent 75% des données.
Considérez le jeu de données suivant de 12 valeurs (triées par ordre croissant) :
5, 7, 8, 12, 13, 14, 18, 19, 22, 25, 28, 30
Pour diviser les données en quartiles, nous commençons par trouver la médiane (Q2) :
Puisqu'il y a 12 points de données (nombre pair), la médiane est la moyenne des 6e et 7e valeurs dans la liste triée. La 6e valeur est 14 et la 7e valeur est 18.
$$ Q_2 = (14 + 18)/2 = 16 $$
Q1 est la médiane de la moitié inférieure des données (les valeurs avant Q2).
La moitié inférieure est :
5, 7, 8, 12, 13, 14
Puisqu'il y a 6 valeurs dans cette moitié (un nombre pair), Q1 est la moyenne des 3e et 4e valeurs.
$$ Q_1 = (8 + 12)/2 = 10 $$
Q3 est la médiane de la moitié supérieure des données (les valeurs après Q2).
La moitié supérieure est :
18, 19, 22, 25, 28, 30
Puisqu'il y a 6 valeurs dans cette moitié (un nombre pair), Q3 est la moyenne des 3e et 4e valeurs.
$$ Q_3 = (22 + 25)/2 = 23.5 $$
Vous pouvez calculer ces mesures facilement avec Pandas en appelant .quantile sur un DataFrame :
import pandas as pd

# Sample DataFrame
data = {
    'values': [10, 15, 20, 25, 30, 35, 40, 45, 50]
}

df = pd.DataFrame(data)

# Calculating measures of spread
iqr = df['values'].quantile(0.75) - df['values'].quantile(0.25)
print("IQR:", iqr)

# Output:
# IQR: 20.0
La variance et l'écart-type
La variance est une mesure de l'étalement des nombres dans un jeu de données. Elle donne une idée de l'écart de chaque nombre du jeu de données par rapport à la moyenne. Une variance plus élevée indique que les nombres sont plus étalés, tandis qu'une variance plus faible signifie qu'ils sont plus proches de la moyenne.
Calculons la variance du jeu de données suivant :
4, 8, 6, 5, 3
La première étape est de calculer la moyenne
$$ mean = (4 + 8 + 6+ 5+ 3)/5 = 5.2 $$
La deuxième étape est de soustraire la moyenne (5.2) de chaque point de données pour trouver les écarts puis de les élever au carré :
(4 - 5.2)**2 = 1.44
(8 - 5.2)**2 = 7.84
(6 - 5.2)**2 = 0.64
(5 - 5.2)**2 = 0.04
(3 - 5.2)**2 = 4.84
La troisième étape serait de sommer toutes les différences au carré et de les diviser par le nombre d'observations moins 1
$$ variance = (1.44 + 7.84 + 0.644 + 0.04 + 4.84)/(5-1) = 3.7 $$
L'écart-type est la racine carrée de la variance et fournit une mesure de dispersion dans les mêmes unités que les données. Un petit écart-type indique que les points de données sont proches de la moyenne, tandis qu'un grand écart-type indique une plus grande dispersion.
Vous pouvez calculer ces mesures facilement avec Pandas en appelant .var() et .std() sur un DataFrame :
import pandas as pd

# Sample DataFrame
data = {
    'values': [10, 15, 20, 25, 30, 35, 40, 45, 50]
}

df = pd.DataFrame(data)

# Calculating measures of spread
variance = df['values'].var()
std_dev = df['values'].std()

print("Variance:", variance)
print("Standard Deviation:", std_dev)

# Output:
# Variance: 187.5
# Standard Deviation: 13.693063937629153
Pandas vous fournit également une fonction pratique — describe(), qui génère un résumé statistique des colonnes numériques de votre DataFrame. Ce résumé inclut le décompte, la moyenne, l'écart-type, le minimum, le maximum et les valeurs des quartiles. Voici un exemple d'utilisation :
import pandas as pd

# Sample DataFrame
data = {
    'values': [10, 15, 20, 25, 30, 35, 40, 45, 50]
}

df = pd.DataFrame(data)

# Generate statistical summary
summary = df.describe()

print(summary)

# Output:
#        values
# count    9.000000
# mean    30.000000
# std     13.228757
# min     10.000000
# 25%     20.000000
# 50%     30.000000
# 75%     40.000000
# max     50.000000
Exercice
Dans cet exercice, vous vous concentrerez uniquement sur la compréhension et le calcul des mesures de dispersion pour les colonnes numériques de votre jeu de données. Vous devrez ouvrir le Notebook Jupyter précédemment créé (summary_statistics.ipynb) dans le dossier exercises et étendre votre analyse en calculant l'étendue, la variance, l'écart-type et l'intervalle interquartile (IQR) pour les colonnes numériques.
Calculer les mesures de dispersion :
- Pour chaque colonne numérique, calculez les mesures de dispersion suivantes :
- Étendue : La différence entre les valeurs maximale et minimale.
- Variance : La moyenne des écarts au carré par rapport à la moyenne.
- Écart-Type : La racine carrée de la variance.
- Intervalle interquartile (IQR) : L'étendue des 50% centraux des données (différence entre le 75e percentile et le 25e percentile).
Solution
Voir la solution
Calculer les mesures de dispersion
numerical_columns = ['age']

for col in numerical_columns:
    # Calculate Range
    range_val = df[col].max() - df[col].min()
    print(f"\nRange for {col}: {range_val}")

    # Calculate Variance
    variance_val = df[col].var()
    print(f"Variance for {col}: {variance_val}")

    # Calculate Standard Deviation
    std_dev_val = df[col].std()
    print(f"Standard Deviation for {col}: {std_dev_val}")

    # Calculate Interquartile Range (IQR)
    iqr_val = df[col].quantile(0.75) - df[col].quantile(0.25)
    print(f"IQR for {col}: {iqr_val}")
Définition d'une valeur aberrante
Une valeur aberrante est une donnée qui diffère significativement des autres observations dans un jeu de données. Les valeurs aberrantes peuvent être causées par une variabilité dans la mesure ou peuvent indiquer des erreurs expérimentales. Il est important de les identifier car elles peuvent avoir un impact substantiel sur les analyses statistiques.
Caractéristiques des valeurs aberrantes
- Significativement différentes des autres observations
- Peuvent être beaucoup plus grandes ou plus petites que les valeurs typiques
- Peuvent impacter les mesures comme la moyenne et l'écart-type
Méthodes pour identifier les valeurs aberrantes
Il existe plusieurs méthodes pour identifier les valeurs aberrantes :
Méthode du Z-Score
Le Z-Score est une méthode statistique qui permet d'identifier les valeurs aberrantes dans un jeu de données. Son principe est simple :
- Il mesure la distance entre une valeur et la moyenne des données, cette distance est exprimée en nombre d'écarts-types. Pour rappel, l'écart-type mesure la dispersion moyenne des valeurs autour de la moyenne d'un ensemble de données. Plus l'écart-type est grand, plus les valeurs sont dispersées, plus il est petit, plus les valeurs sont regroupées près de la moyenne.
- La formule du Z-Score est : $Z = (X - μ) / σ$
- où $X$ est la valeur observée
- $μ$ est la moyenne
- $σ$ est l'écart-type
Par convention, une valeur est considérée comme aberrante si :
- Son Z-Score est supérieur à +3 (très au-dessus de la moyenne)
- Ou son Z-Score est inférieur à -3 (très en-dessous de la moyenne)
Cette méthode permet de détecter automatiquement les valeurs qui s'écartent significativement de la tendance centrale des données.
Voici un exemple d'identification des valeurs aberrantes utilisant la méthode du Z-Score dans pandas :
import pandas as pd
import numpy as np

# Larger dataset with a detectable outlier
data = pd.DataFrame({"values": [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 1000]})

# Calculate mean
mean = np.mean(data["values"])

# Calculate standard deviation
std_dev = np.std(data["values"])

# Calculate z-score
data["z_score"] = (data["values"] - mean) / std_dev

# Detect outliers (z-score > 3 or < -3)
data["outlier"] = data["z_score"].apply(lambda x: "Outlier" if abs(x) > 3 else "Normal")

print(data)

# Output:
#     values   z_score  outlier
# 0        1 -0.331952   Normal
# 1        2 -0.328455   Normal
# 2        3 -0.324957   Normal
# 3        4 -0.321460   Normal
# 4        5 -0.317962   Normal
# 5        6 -0.314464   Normal
# 6        7 -0.310967   Normal
# 7        8 -0.307469   Normal
# 8        9 -0.303972   Normal
# 9       10 -0.300474   Normal
# 10    1000  3.162133  Outlier
Méthode de l'intervalle interquartile (IQR)
Pour rappel, l’IQR (Intervalle Interquartile) est une méthode qui aide à repérer les valeurs atypiques en analysant la répartition des données.
On commence par identifier deux seuils clés :
- Q1 (1er quartile) : la valeur en dessous de laquelle se trouvent 25 % des données.
- Q3 (3e quartile) : la valeur en dessous de laquelle se trouvent 75 % des données.
L’IQR est la différence entre ces deux quartiles (IQR = Q3 - Q1).
Une valeur est considérée comme extrême si elle est beaucoup plus petite que Q1 ou beaucoup plus grande que Q3. Concrètement, on considère comme aberrantes :
- Les valeurs inférieures à Q1 - 1,5 × IQR
- Les valeurs supérieures à Q3 + 1,5 × IQR
Cette méthode est particulièrement efficace lorsque les données contiennent des valeurs extrêmes qui faussent la moyenne.
Voici un exemple d'identification des valeurs aberrantes utilisant la méthode IQR dans pandas :
import pandas as pd

# Create a sample dataset
data = pd.DataFrame({"values": [-100, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 100]})

# Calculate Q1, Q3, and IQR
Q1 = data["values"].quantile(0.25)
Q3 = data["values"].quantile(0.75)
IQR = Q3 - Q1

# Define bounds for outliers
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR

# Identify outliers
outliers = data.loc[(data["values"] < lower_bound) | (data["values"] > upper_bound)]

print("Q1:", Q1)
print("Q3:", Q3)
print("IQR:", IQR)
print("Lower bound:", lower_bound)
print("Upper bound:", upper_bound)
print("\nOutliers:")
print(outliers)

# Output:
# Q1: 2.75
# Q3: 8.25
# IQR: 5.5
# Lower bound: -5.5
# Upper bound: 16.5

# Outliers:
#     values
# 0     -100
# 11     100
Dans cet exemple, nous utilisons pandas pour calculer l'IQR et identifier les valeurs aberrantes dans un jeu de données échantillon. La valeur aberrante (valeur 100) est correctement identifiée en utilisant cette méthode.
Traitement des valeurs aberrantes
Une fois identifiées, il existe plusieurs façons de traiter les valeurs aberrantes :
- Les supprimer si elles sont dues à des erreurs
- Transformer les données pour réduire leur impact
- Utiliser des statistiques descriptives qui sont moins sensibles aux valeurs aberrantes
- Les conserver mais noter leur présence et leur impact potentiel sur les analyses
La méthode appropriée pour traiter les valeurs aberrantes dépend du contexte spécifique des données et des objectifs de l'analyse.
En savoir plus : Traitement des valeurs aberrantes
Excellent travail ! Vous comprenez maintenant comment distinguer les différents types de données, tels que les données quantitatives (numériques) et qualitatives (catégorielles). Savoir si les données sont continues ou discrètes ou si elles sont classées comme nominales ou ordinales vous aide à choisir les mesures statistiques appropriées pour l'analyse. Par exemple, utiliser des mesures comme la moyenne ou la médiane pour les données numériques, tout en s'appuyant sur les fréquences ou le mode pour les données catégorielles.
Vous avez également appris à utiliser les mesures de tendance centrale - comme la moyenne, la médiane et le mode - pour identifier le "centre" de la distribution des données. Ces métriques permettent de comprendre rapidement la valeur typique ou moyenne dans un jeu de données, vous aidant à résumer de grandes quantités d'informations en insights clés.
Enfin, vous avez exploré les mesures de dispersion, comme l'étendue, l'intervalle interquartile (IQR) et l'écart-type, qui aident à décrire la variabilité ou la dispersion des données.
Continuez votre excellent travail !