Regroupement et agrégation de données
Prérequis
Avant de plonger dans cette leçon, vous devriez être familier avec :
- Le travail avec les DataFrames Pandas
- Les statistiques descriptives de base
Objectifs pédagogiques
À la fin de cette leçon, vous serez capable de :
- Comprendre et utiliser la méthode
.groupby()pour organiser et analyser des données. - Appliquer des fonctions d'agrégation pour résumer les données groupées (comme la somme, la moyenne, etc.).
- Explorer des techniques avancées d'analyse, telles que l'agrégation personnalisée, le filtrage des groupes et le classement des données.
Lors de l'analyse de données, il est souvent nécessaire de décomposer de grands jeux de données en groupes plus petits et plus gérables pour en tirer des insights significatifs. Par exemple, vous pourriez avoir besoin de décomposer les données de ventes par région, évaluer le comportement des clients par segment, ou analyser les métriques de performance par département. Dans ces cas, l'examen des moyennes globales ou des totaux sur l'ensemble du jeu de données est souvent insuffisant.
La fonction groupby() de Pandas est un outil puissant qui divise vos données en groupes basés sur une ou plusieurs variables catégorielles, applique des fonctions d'agrégation à chaque groupe, et combine les résultats. Cette approche "diviser-appliquer-combiner" résume les données au sein de chaque groupe, offrant des insights sur les caractéristiques, la variabilité et les tendances.
Nous commencerons par les bases et explorerons progressivement des opérations plus complexes comme le groupement multi-niveaux, l'agrégation personnalisée et le filtrage de groupes.
Comme mentionné précédemment, le groupement est basé sur le concept Diviser-Appliquer-Combiner. Comme montré dans la figure, la fonction groupby() de Pandas divise le DataFrame en groupes basés sur des critères spécifiés. Une fois groupées, nous pouvons appliquer diverses opérations à chaque groupe indépendamment. Ensuite, les résultats sont combinés pour former un nouveau DataFrame ou Series.
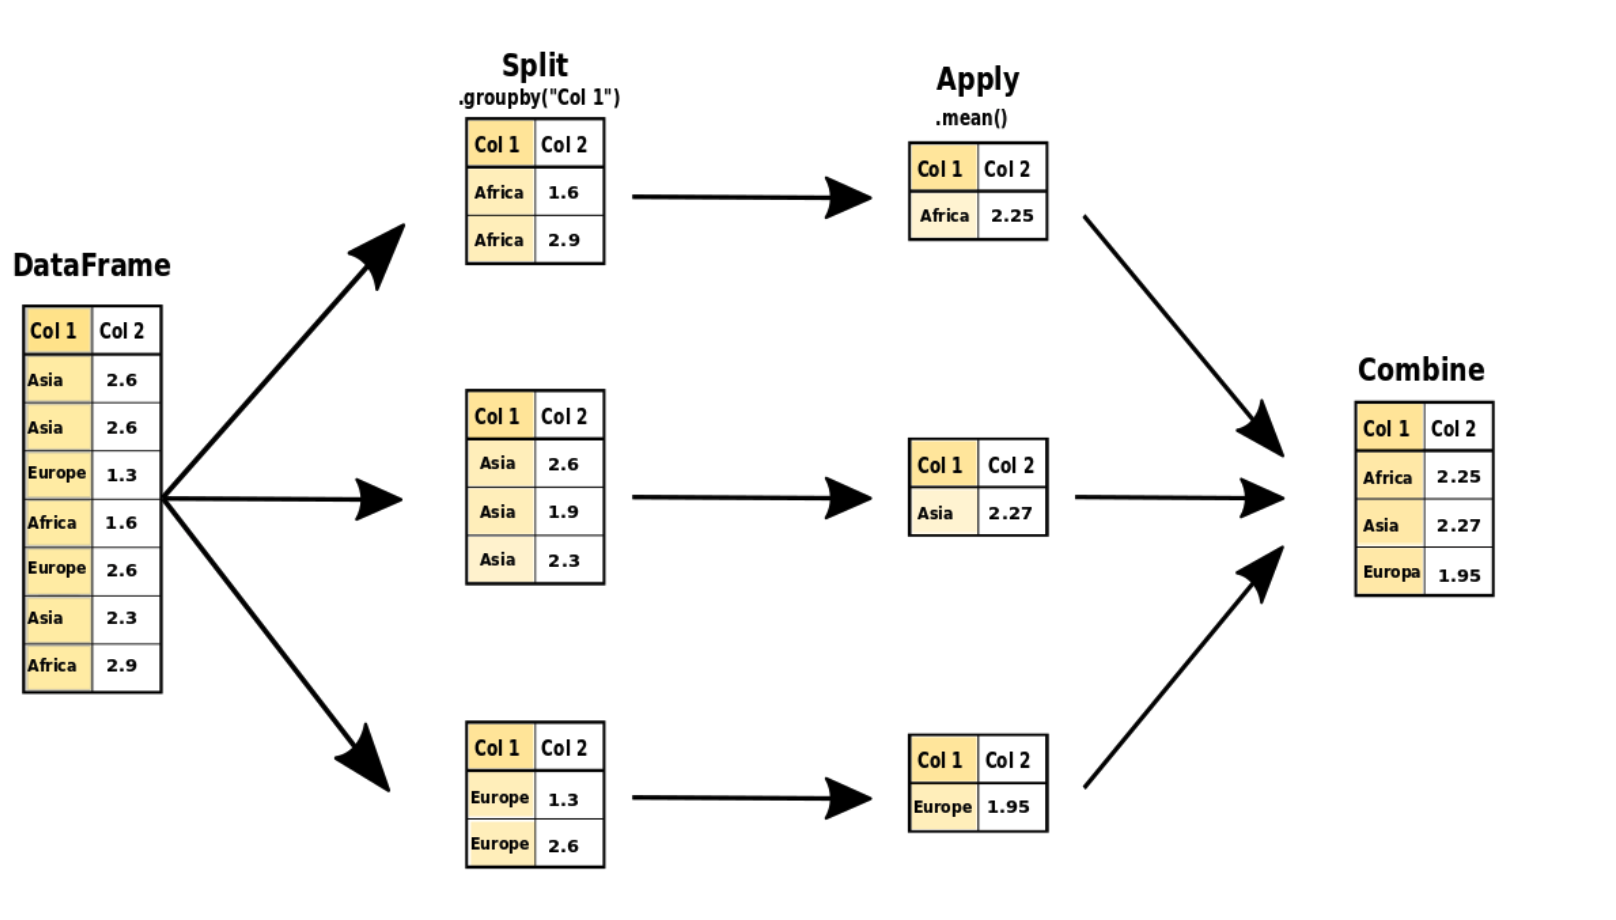
Explorons la syntaxe de base de la fonction groupby() dans Pandas. Nous utiliserons un jeu de données représentant des données d'inventaire à travers différents entrepôts :
import pandas as pd

data = {
    'warehouse': ['warehouse_1', 'warehouse_2', 'warehouse_1', 'warehouse_3', 'warehouse_2', 'warehouse_3', 'warehouse_1', 'warehouse_2'],
    'product': ['widget_a', 'widget_b', 'widget_a', 'widget_c', 'widget_b', 'widget_c', 'widget_b', 'widget_a'],
    'stock_level': [150, 120, 100, 200, 130, 180, 110, 115],
    'reorder_level': [50, 60, 50, 75, 60, 70, 55, 65],
    'price_per_unit': [10, 12, 10, 8, 12, 8, 12, 10]
}

df = pd.DataFrame(data)
grouped = df.groupby(by=['warehouse'])
print(grouped)

# output:
# <pandas.core.groupby.generic.dataframe_group_by object at 0x...>
Dans cet exemple, le DataFrame est groupé par la colonne 'Warehouse'. Le résultat est un objet DataFrameGroupBy, une structure spéciale qui stocke les informations de groupement sans effectuer immédiatement de calculs. Vous pouvez considérer cet objet comme une collection de plus petits DataFrames, chacun représentant un entrepôt et contenant uniquement les lignes liées à cet entrepôt.
Vous pouvez extraire tous les enregistrements d'un groupe spécifique en utilisant la méthode .get_group(). Par exemple, si vous voulez voir les données pour Warehouse_1, vous pouvez faire :
# using .get_group() to extract a specific group
warehouse1_group = grouped.get_group('warehouse_1')
print("\\nwarehouse 1 group:\\n")
print(warehouse1_group)

# output:
# warehouse 1 group:
#
#     warehouse product  stock_level  reorder_level  price_per_unit
# 0  warehouse_1 widget_a         150             50              10
# 2  warehouse_1 widget_a         100             50              10
# 6  warehouse_1 widget_b         110             55              12
C'est utile quand vous voulez vous concentrer sur l'analyse d'un groupe particulier en isolation.
Vous pouvez également itérer à travers chaque groupe pour voir comment fonctionne la division :
# iterating through each group in the grouped object
for name, group in grouped:
    print(f"group: {name}")
    print(group)
    print()  # add a blank line for better readability

# output
# group: warehouse_1
#     warehouse  product  stock_level  reorder_level  price_per_unit
# 0  warehouse_1 widget_a          150             50              10
# 2  warehouse_1 widget_a          100             50              10
# 6  warehouse_1 widget_b          110             55              12

# group: warehouse_2
#     warehouse  product  stock_level  reorder_level  price_per_unit
# 1  warehouse_2 widget_b          120             60              12
# 4  warehouse_2 widget_b          130             60              12
# 7  warehouse_2 widget_a          115             65              10

# group: warehouse_3
#     warehouse  product  stock_level  reorder_level  price_per_unit
# 3  warehouse_3 widget_c          200             75               8
# 5  warehouse_3 widget_c          180             70               8
Agrégation en une seule colonne
Supposons que vous vouliez connaître les niveaux de stock totaux dans chaque entrepôt. Vous pouvez grouper par Warehouse et agréger la colonne Stock_Level en utilisant sum() :
# Group by warehouse and sum the stock levels
total_stock_level_w = df.groupby('warehouse')['stock_level'].sum()
print(total_stock_level_w)

# Output:
# warehouse
# warehouse_1    360
# warehouse_2    365
# warehouse_3    380
# Name: stock_level, dtype: int64
Supposons que vous vouliez identifier non seulement l'entrepôt avec le stock total le plus élevé mais aussi les entrepôts avec une grande variabilité dans les niveaux de stock et le prix moyen par unité à travers différents emplacements. Vous pouvez appliquer plusieurs fonctions d'agrégation en une seule étape en utilisant la fonction agg() :
# Group by warehouse and aggregate stock level and price per unit
summary_stock_price = df.groupby('warehouse').agg({
    'stock_level': ['sum', 'mean', 'median', 'count', 'min', 'max'],
    'price_per_unit': 'mean'
})

# Display the summary statistics
print(summary_stock_price)

# Output:
#             stock_level                                    price_per_unit
#                    sum   mean median count  min  max              mean
# warehouse
# warehouse_1        360  120.0    110     3  100  150        10.666667
# warehouse_2        365  121.7    120     3  115  130        11.333333
# warehouse_3        380  190.0    190     2  180  200         8.000000
Pour chaque entrepôt, nous obtenons un résumé des niveaux de stock et des prix.
Les colonnes du DataFrame résultant sont organisées dans une structure hiérarchique, avec les fonctions d'agrégation comme niveau supérieur et les noms de colonnes originaux comme second niveau.
Pour accéder à des données spécifiques dans ce DataFrame à index multiple, par exemple :
# Access the sum column of stock_level
print(summary_stock_price['stock_level']['sum'])

#ou pour un indexage plus explicite avec la notation .loc
# Access the sum column of stock_level
print(summary_stock_price.loc[:, ('stock_level', 'sum')])
Agrégation en plusieurs colonnes
Que faire si nous devons analyser des données basées sur plusieurs catégories ? Nous pouvons grouper par plus d'une colonne pour créer des agrégations multi-niveaux. Par exemple, groupons les données par Warehouse et Product pour examiner les niveaux de stock et le niveau de réapprovisionnement :
# Group by warehouse and product, then aggregate stock level and reorder level
multi_grouped = df.groupby(['warehouse', 'product']).agg({
    'stock_level': 'sum',
    'reorder_level': 'mean'
})
print(multi_grouped)

# Output:
#                         stock_level  reorder_level
# warehouse   product
# warehouse_1 widget_a           250            50.0
#             widget_b           110            55.0
# warehouse_2 widget_a           115            65.0
#             widget_b           250            60.0
# warehouse_3 widget_c           380            72.5
Le DataFrame résultant utilise un multi-index (avec Warehouse et Product comme niveaux d'index). Vous pouvez accéder à des groupes spécifiques en utilisant la méthode .loc[] ou effectuer des analyses supplémentaires en dépliant ou en remodelant les données.
Par exemple, si vous voulez accéder aux données pour Warehouse_1 et Widget_A, vous pourriez utiliser :
# Access data for a specific warehouse and product combination
print(multi_grouped.loc[('warehouse_1', 'widget_a')])

# Output:
# stock_level      250.0
# reorder_level     50.0
# Name: (warehouse_1, widget_a), dtype: float64
Lorsque vous avez des données groupées avec plusieurs niveaux (multi-index), cela peut compliquer les manipulations ou la lecture. Réinitialiser l'index en utilisant reset_index() simplifie la structure et rend les données plus faciles à utiliser, surtout pour des calculs simples ou pour les exporter.
Cela transformera l'index complexe en table avec colonnes normales, simplifiant ainsi la manipulation des données :
# Reset the multi-index to create a flat DataFrame
reset_df = multi_grouped.reset_index()
print(reset_df)

# Output:
#      warehouse  product  stock_level  reorder_level
# 0  warehouse_1 widget_a         250           50.0
# 1  warehouse_1 widget_b         110           55.0
# 2  warehouse_2 widget_a         115           65.0
# 3  warehouse_2 widget_b         250           60.0
# 4  warehouse_3 widget_c         380           72.5
Si vous voulez réinitialiser uniquement l'index Product tout en gardant Warehouse comme index, vous pouvez utiliser la fonction reset_index() avec le paramètre level='Product'.
Exercice
Groupement et agrégation des données de ventes
Votre responsable vous a demandé d'analyser les données de ventes pour découvrir des insights clés qui aideront à améliorer les stratégies commerciales. Vous utiliserez le jeu de données complete_data_with_time_features.csv, qui contient les transactions de vente à travers différentes régions, produits et périodes. Ce fichier se trouve dans votre dossier exercise du répertoire data_wrangling.
Aperçu du jeu de données :
Nous utiliserons les colonnes suivantes :
region_id :La région où la vente a eu lieuproduct_name: Le produit venduquantity: Le nombre d'unités venduesprice: Le prix par unité du produit
Assurez-vous de copier complete_data_with_time_features.csv dans le dossier exercise du dossier Grouping_Aggregating.
Tâche 1 : Configurer votre Notebook
- Ouvrez un nouveau notebook Jupyter nommé
sales_groupby_aggregation.ipynbdans le dossierexercisedu dossierGrouping_Aggregating. - Chargez le jeu de données
complete_data_with_time_features.csvdans un DataFrame pandas. :paperclip: complete_data_with_time_features.csv
Tâche 2 : Groupement et agrégation
-
Grouper par région et agréger les ventes :
- Votre responsable veut savoir quelles régions performent le mieux en termes de ventes. Groupez les données par la colonne
region_id. - Créez la colonne 'sales_amount' en multipliant les colonnes
quantityetprice. - Calculez les ventes totales pour chaque région.
Conseil : Utilisez la fonction
groupby()pour grouper les données parregion_idpuis utilisez la fonctionsum()pour agréger les ventes totales. Si besoin, vous pouvez transformer le nom des colonnes de votre DataFramedfen minuscule avec la commande :df.columns = df.columns.str.lower(). - Votre responsable veut savoir quelles régions performent le mieux en termes de ventes. Groupez les données par la colonne
-
Analyser les données pour des groupes spécifiques :
-
Étape 1 : Identifier la région avec les ventes totales les plus élevées
- Utilisez la fonction idxmax() sur les ventes totales agrégées pour trouver la région avec les ventes totales les plus élevées.
- Stockez le résultat dans une variable nommée
top_region.
Conseil :
idxmax()renvoie l'index de la valeur maximum dans une Series. Utilisez cette fonction pour trouver la région avec les ventes totales les plus élevées. -
Étape 2 : Extraire les données pour la région avec les ventes totales les plus élevées
- Filtrez le DataFrame original pour n'inclure que les lignes où la
regionest égale àtop_region. Cela vous donnera toutes les données de ventes pour la région avec les ventes totales les plus élevées. - Stockez ce DataFrame filtré dans une variable nommée
region_data.
Conseil : Utilisez l'indexation booléenne pour filtrer le DataFrame.
- Filtrez le DataFrame original pour n'inclure que les lignes où la
-
Étape 3 : Trouver les 3 produits avec la quantité vendue la plus élevée dans la meilleure région
- Maintenant que vous avez les données de ventes pour la région avec les ventes totales les plus élevées (
region_data), groupez ces données parproductet calculez laquantitytotale vendue pour chaque produit. - Utilisez la fonction
nlargest()pour trouver les 3 produits avec la quantité totale vendue la plus élevée.
Conseil :
nlargest(3)renverra les 3 valeurs les plus élevées de la Series. - Maintenant que vous avez les données de ventes pour la région avec les ventes totales les plus élevées (
-
Solution
Voir la solution
Grouper par région et agréger les ventes
# Create a 'sales_amount' column
df['sales_amount'] = df['quantity'] * df['price']

# Group by region and calculate total sales
total_sales_by_region = df.groupby('region_id')['sales_amount'].sum()

# Display the result
print(total_sales_by_region)
Voir la solution
Identifier la région avec les ventes totales les plus élevées
# Use idxmax to find the region with the maximum total sales
top_region = total_sales_by_region.idxmax()
print(f"The region with the highest total sales is: {top_region}")
Voir la solution
Extraire les données pour la région avec les ventes totales les plus élevées
# Extract data for the top region
region_data = df[df['region_id'] == top_region]
print(region_data.head())
Voir la solution
Trouver les 3 produits avec la quantité vendue la plus élevée dans la meilleure région
# Group by product and calculate total quantity sold in the top region
total_quantity_by_product = region_data.groupby('product')['quantity'].sum()

# Find the top 3 products with the highest quantity sold
top_products = total_quantity_by_product.nlargest(3)
print("Top 3 products by quantity sold in the top region:")
print(top_products)
Les métriques de base comme la somme, la moyenne, ou le décompte ne racontent souvent pas toute l'histoire. Par exemple, si vous gérez des stocks dans plusieurs entrepôts, vous pourriez vouloir voir comment les niveaux de stock varient. Vous pouvez faire cela en calculant l'étendue ou l'intervalle interquartile (IQR). Une autre mesure utile est le coefficient de variation (CV), qui vous indique à quel point les niveaux de stock fluctuent par rapport à la moyenne.
Continuons à utiliser le jeu de données représentant les données d'inventaire à travers différents entrepôts :
data = {
    'Warehouse': ['Warehouse_1', 'Warehouse_1', 'Warehouse_2', 'Warehouse_2', 'Warehouse_3'],
    'Product': ['Widget_A', 'Widget_B', 'Widget_A', 'Widget_B', 'Widget_C'],
    'Stock_Level': [250, 110, 115, 250, 380],
    'Reorder_Level': [50.0, 55.0, 65.0, 60.0, 72.5]
}

df = pd.DataFrame(data)
print(df)

# Output:
#      Warehouse  Product  Stock_Level  Reorder_Level
# 0  Warehouse_1 Widget_A         250           50.0
# 1  Warehouse_1 Widget_B         110           55.0
# 2  Warehouse_2 Widget_A         115           65.0
# 3  Warehouse_2 Widget_B         250           60.0
# 4  Warehouse_3 Widget_C         380           72.5
D'abord, définissons nos fonctions d'agrégation personnalisées pour calculer l'étendue, le coefficient de variation et l'intervalle interquartile des niveaux de stock :
def stock_range(series):
    return series.max() - series.min()

def coeff_variation(series):
    return series.std() / series.mean()

def interquartile_range(series):
    q3 = series.quantile(0.75)
    q1 = series.quantile(0.25)
    return q3 - q1
Maintenant, groupons les données par la colonne Warehouse et appliquons ces fonctions personnalisées sur la colonne Stock_Level en utilisant la méthode agg() :
custom_agg = df.groupby('Warehouse').agg({
    'Stock_Level': [stock_range, coeff_variation, interquartile_range],
    'Reorder_Level': 'mean'
})

print("Custom Aggregation Results:")
print(custom_agg)

# Output:
# Custom Aggregation Results:
#
#             Stock_Level                                          Reorder_Level
#              stock_range      coeff_variation interquartile_range         mean
# Warehouse
# Warehouse_1        140.0             0.393855              70.00         52.5
# Warehouse_2        135.0             0.384615              67.50         62.5
# Warehouse_3          0.0             0.000000               0.00         72.5
Filtrage des groupes basé sur les valeurs agrégées
Imaginez que vous analysez les niveaux d'inventaire à travers plusieurs entrepôts et voulez inclure uniquement ceux avec un niveau de stock total au-dessus d'un certain seuil. En fixant un seuil (par exemple, 370 unités), vous pouvez filtrer les entrepôts qui pourraient être insignifiants pour votre analyse.
Cet exemple démontre comment filtrer au sein des groupes basés sur les valeurs agrégées :
def filter_by_total_stock(group):
    return group['Stock_Level'].sum() > 370

filtered_df = df.groupby('Warehouse').filter(filter_by_total_stock)

print("\nFiltered Data (Total Stock Level > 370):")

print(filtered_df)

# Output:
#      Warehouse  Product  Stock_Level  Reorder_Level
# 4  Warehouse_3 Widget_C         380           72.5
La fonction filter_by_total_stock filtre les groupes qui ne répondent pas à une condition spécifiée. Dans ce cas, elle filtre basé sur le niveau de stock total dans chaque groupe. L'entrée group représente chaque groupe créé par groupby(). Dans ce contexte, chaque groupe est essentiellement un sous-ensemble du DataFrame original, contenant les lignes qui appartiennent au même entrepôt.
Nous pouvons aussi filtrer en utilisant une des fonctions d'agrégation personnalisées définies précédemment, avec un seuil de 50 ici :
def stock_range(series): # custom aggregation function
    return series.max() - series.min()

def filter_by_stock_range(group):
    return stock_range(group['Stock_Level']) > 50

filtered_df = df.groupby('Warehouse').filter(filter_by_stock_range)

print("\nFiltered Data (Stock Range > 50):")
print(filtered_df)

# Output:
#      Warehouse  Product  Stock_Level  Reorder_Level
# 0  Warehouse_1 Widget_A         250           50.0
# 1  Warehouse_1 Widget_B         110           55.0
# 2  Warehouse_2 Widget_A         115           65.0
# 3  Warehouse_2 Widget_B         250           60.0
Exercice
Création d’une nouvelle métrique d’agrégation
Vous avez appris à calculer l’étendue, le coefficient de variation et l’intervalle interquartile des niveaux de stock. Maintenant, ajoutez une nouvelle métrique personnalisée qui calcule l’écart moyen absolu (Mean Absolute Deviation, MAD) des niveaux de stock dans chaque entrepôt.
Objectif :
- Définissez une fonction
mean_absolute_deviation(series)qui calcule l’écart moyen absolu d’une série de niveaux de stock. - Appliquez cette fonction avec
groupby().agg()pour obtenir la MAD de Stock_Level pour chaque entrepôt. - Affichez les résultats sous forme de DataFrame.
Indices :
-
La MAD est calculée comme ceci :
$$ MAD = \frac{1}{n} \sum_{i=1}^{n} |x_i - \bar{x}| $$
où $\bar{x}$ est la moyenne de la série et $x_i$ sont les valeurs individuelles.
-
Utilise
series.mean()pour calculer la moyenne $\bar{x}$ d’une série Pandas. -
Soustrais cette moyenne à chaque élément de la série, puis prends la valeur absolue avec
.abs(). -
****Fais la moyenne des écarts absolus avec
.mean(). -
Applique cette fonction aux niveaux de stock dans chaque entrepôt avec
.groupby('Warehouse').agg(...).
Début du code :
import pandas as pd

data = {
    "Warehouse": [
        "Warehouse_1",
        "Warehouse_1",
        "Warehouse_2",
        "Warehouse_2",
        "Warehouse_3",
    ],
    "Product": ["Widget_A", "Widget_B", "Widget_A", "Widget_B", "Widget_C"],
    "Stock_Level": [250, 110, 115, 250, 380],
    "Reorder_Level": [50.0, 55.0, 65.0, 60.0, 72.5],
}

df = pd.DataFrame(data)

# TODO: Define the mean_absolute_deviation() function
# TODO: Group by 'Warehouse' and apply this function with agg()
# TODO: Display the resulting DataFrame

# Output:
# Custom Aggregation Results:
#                         Stock_Level        Reorder_Level
#             mean_absolute_deviation   mean          mean
# Warehouse
# Warehouse_1                    70.0  180.0          52.5
# Warehouse_2                    67.5  182.5          62.5
# Warehouse_3                     0.0  380.0          72.5
Solution
Voir la solution
Explication :
1. Définition de la fonction mean_absolute_deviation()
- On calcule la moyenne de la série avec
.mean(). - On soustrait cette moyenne à chaque valeur de la série.
- On prend la valeur absolue de ces écarts et on calcule la moyenne de ces valeurs absolues.
2. Application de groupby().agg()
- On groupe les données par Warehouse.
- On applique la fonction
mean_absolute_deviationsurStock_Level. - On ajoute également la moyenne (
mean) pour voir la comparaison. - On calcule aussi la moyenne de
Reorder_Levelpour voir les tendances générales.
3. Affichage des résultats
- Un DataFrame est affiché avec la MAD des niveaux de stock pour chaque entrepôt.
import pandas as pd

# Inventory data
data = {
    "Warehouse": [
        "Warehouse_1",
        "Warehouse_1",
        "Warehouse_2",
        "Warehouse_2",
        "Warehouse_3",
    ],
    "Product": ["Widget_A", "Widget_B", "Widget_A", "Widget_B", "Widget_C"],
    "Stock_Level": [250, 110, 115, 250, 380],
    "Reorder_Level": [50.0, 55.0, 65.0, 60.0, 72.5],
}

df = pd.DataFrame(data)

# Function to calculate Mean Absolute Deviation (MAD)
def mean_absolute_deviation(series):
    mean = series.mean()
    return (series - mean).abs().mean()

# Apply custom aggregation
custom_agg = df.groupby("Warehouse").agg(
    {"Stock_Level": [mean_absolute_deviation, "mean"], "Reorder_Level": "mean"}
)

print("Custom Aggregation Results:")
print(custom_agg)

# Output:
# Custom Aggregation Results:
#                         Stock_Level        Reorder_Level
#             mean_absolute_deviation   mean          mean
# Warehouse
# Warehouse_1                    70.0  180.0          52.5
# Warehouse_2                    67.5  182.5          62.5
# Warehouse_3                     0.0  380.0          72.5
Lorsque vous travaillez avec des données groupées dans Pandas, vous avez souvent besoin de plus que de simples résumés agrégés comme les totaux ou les moyennes. Par exemple, si vous analysez les niveaux de stock à travers plusieurs entrepôts, vous pourriez vouloir voir comment le stock de chaque produit se compare au niveau de stock moyen dans son entrepôt. Vous pourriez aussi avoir besoin de classer les produits au sein de chaque entrepôt basé sur les niveaux de stock pour identifier quels articles sont les plus ou moins stockés.

Souvent, vous devez maintenir la structure originale de votre jeu de données tout en effectuant des calculs qui prennent en compte le contexte au niveau du groupe. Pour cela, vous pouvez utiliser la fonction `transform()` dans Pandas. Considérons à nouveau le jeu de données représentant les données d'inventaire à travers différents entrepôts :

```python
data = {
    'warehouse': ['warehouse_1', 'warehouse_1', 'warehouse_2', 'warehouse_2', 'warehouse_3'],
    'product': ['widget_a', 'widget_b', 'widget_a', 'widget_b', 'widget_c'],
    'stock_level': [250, 110, 115, 250, 380],
    'reorder_level': [50.0, 55.0, 65.0, 60.0, 72.5]
}

df = pd.DataFrame(data)
print(df)

# Output:
#      warehouse  product  stock_level  reorder_level
# 0  warehouse_1 widget_a         250           50.0
# 1  warehouse_1 widget_b         110           55.0
# 2  warehouse_2 widget_a         115           65.0
# 3  warehouse_2 widget_b         250           60.0
# 4  warehouse_3 widget_c         380           72.5
Supposons que nous devons calculer comment le niveau de stock de chaque produit se compare au niveau de stock moyen dans son entrepôt :
# Calculate the mean stock level for each warehouse
groups_mean = df.groupby(by=['warehouse'])['stock_level'].transform('mean')
print(groups_mean)

# Output:
# 0    180.0
# 1    180.0
# 2    182.5
# 3    182.5
# 4    380.0
# Name: stock_level, dtype: float64

# Calculate the difference between each product's stock level and its warehouse's mean
df['stock_average'] = df['stock_level'] - groups_mean

print(df)

# Output:
#      warehouse   product  stock_level  reorder_level  stock_average
# 0  warehouse_1  widget_a         250           50.0           70.0
# 1  warehouse_1  widget_b         110           55.0          -70.0
# 2  warehouse_2  widget_a         115           65.0          -67.5
# 3  warehouse_2  widget_b         250           60.0           67.5
# 4  warehouse_3  widget_c         380           72.5            0.0
Ce code calcule le niveau de stock moyen pour chaque entrepôt et assigne cette moyenne à chaque ligne appartenant à cet entrepôt. Décomposons la sortie :
- Lignes 0 et 1 (180.0) : Elles appartiennent à warehouse_1, qui a un niveau de stock moyen de 180.
- Lignes 2 et 3 (182.5) : Elles appartiennent à warehouse_2, avec un niveau de stock moyen de 182.5.
- Ligne 4 (380.0) : Elle appartient à warehouse_3, qui n'a qu'un seul article avec un niveau de stock de 380.
La fonction transform() applique le calcul de la moyenne à chaque groupe (entrepôt) puis diffuse le résultat à la forme originale du DataFrame, maintenant l'index original.
Après avoir calculé le niveau de stock moyen pour chaque entrepôt en utilisant la fonction transform('mean'), le code soustrait ensuite cette moyenne du niveau de stock de chaque produit pour créer une nouvelle colonne appelée stock_average.
Transformations personnalisées
Comme avec l'agrégation, nous pouvons définir des transformations personnalisées à appliquer au sein des groupes. Par exemple, nous pourrions vouloir calculer le pourcentage de contribution du niveau de stock de chaque produit au stock total dans son entrepôt. Définissons une fonction pour cet objectif :
# Define a function to calculate the percentage of stock for each product within its warehouse
def stock_percentage(group):
    # Calculate the total stock level for the group (warehouse)
    total_group = group['stock_level'].sum()
    # Return the percentage of each product's stock relative to the total
    return group['stock_level'] / total_group * 100
Maintenant, appliquons cette transformation à chaque groupe et créons une nouvelle colonne :
# Apply the custom transformation to calculate stock percentage for each product within its warehouse
df['stock_perc'] = df.groupby('warehouse')['stock_level'].transform(stock_percentage)

# Display the updated DataFrame
print(df)

# Output:
#      warehouse  product  stock_level  reorder_level  stock_average  stock_perc
# 0  warehouse_1 widget_a         250           50.0           70.0      69.44
# 1  warehouse_1 widget_b         110           55.0          -70.0      30.56
# 2  warehouse_2 widget_a         115           65.0          -67.5      31.51
# 3  warehouse_2 widget_b         250           60.0           67.5      68.49
# 4  warehouse_3 widget_c         380           72.5            0.0     100.00
Imputation des valeurs manquantes en fonction des groupes avec transform()
Dans un environnement commercial complexe, comme la gestion des stocks à travers plusieurs entrepôts, il est essentiel que les données soient aussi précises que possible pour prendre des décisions éclairées. Lorsque certaines valeurs sont manquantes, il peut être plus pertinent de les imputer en utilisant des statistiques spécifiques à chaque groupe (par exemple, par entrepôt), plutôt que de se fier à une mesure globale comme la moyenne ou la médiane générale. Par exemple, les niveaux de stock peuvent varier considérablement d'un entrepôt à l'autre, en fonction de la demande locale, des capacités de stockage, ou des stratégies de réapprovisionnement.
Si vous remplacez les valeurs manquantes par la moyenne globale, vous risquez d'obtenir des données qui ne reflètent pas ces différences et qui pourraient fausser les décisions liées à l'approvisionnement ou à la gestion des stocks.
Voyons comment résoudre cela en considérant à nouveau le jeu de données représentant les données d'inventaire à travers différents entrepôts où vous avez des valeurs manquantes dans la colonne stock_level et reorder_level :
# Define the data dictionary
data = {
    'warehouse': ['warehouse_1', 'warehouse_1', 'warehouse_1', 'warehouse_2', 'warehouse_2', 'warehouse_3'],
    'product': ['widget_a', 'widget_b', 'widget_c', 'widget_a', 'widget_b', 'widget_c'],
    'stock_level': [250, None, 115, 134, 250, 380],
    'reorder_level': [50.0, None, 65.0, 45.0, 60.0, 72.5]
}

# Create DataFrame
df = pd.DataFrame(data)

# Display the number of missing values in each column
print(df.isna().sum())

# Output:
# warehouse      0
# product        0
# stock_level    1
# reorder_level  1
# dtype: int64
Créons une fonction qui définit notre stratégie d'imputation puis appliquons-la à nos données groupées en utilisant la méthode transform().
# Define the imputation function
def impute(series):
    return series.fillna(series.mean())

# Apply the function using transform
df[['stock_level', 'reorder_level']] = df.groupby('warehouse')[['stock_level', 'reorder_level']].transform(impute)

print(df)

# Output:
#      warehouse   product  stock_level  reorder_level
# 0  warehouse_1  widget_a       250.0           50.0
# 1  warehouse_1  widget_b       182.5           57.5
# 2  warehouse_1  widget_c       115.0           65.0
# 3  warehouse_2  widget_a       134.0           45.0
# 4  warehouse_2  widget_b       250.0           60.0
# 5  warehouse_3  widget_c       380.0           72.5
Dans ce code, nous définissons une fonction d'imputation qui remplit les valeurs manquantes dans une série avec sa moyenne. En utilisant transform(), la fonction est appliquée aux colonnes stock_level et reorder_level, groupées par la colonne warehouse. L'imputation se produit au sein de chaque groupe séparément, et les valeurs mises à jour sont directement appliquées aux colonnes originales.
Excellent travail ! Vous savez maintenant comment utiliser les fonctions de groupement comme groupby() pour diviser un DataFrame en groupes basés sur des variables catégorielles et effectuer des opérations d'agrégation au sein des groupes, en utilisant des méthodes comme sum() oumean() pour calculer des statistiques résumées pour chaque catégorie.
Enfin, vous avez exploré comment utiliser des transformations personnalisées au sein des groupes pour effectuer des calculs plus complexes, comme appliquer des fonctions pour standardiser les valeurs au sein de chaque groupe, calculer des sommes cumulatives, ou normaliser des données entre 0 et 1. Les techniques comme transform() vous permettent d'aller au-delà des agrégations standard et de créer des calculs personnalisés adaptés à vos besoins spécifiques d'analyse.
Continuez votre excellent travail !