Prédictions statistiques
Prérequis
Avant de plonger dans cette leçon, vous devriez être familier avec :
- Le travail avec les DataFrames Pandas
- Les statistiques descriptives de base
- Les concepts de base en visualisation de données
- Les notions de base en algèbre linéaire
Objectifs pédagogiques
À la fin de cette leçon, vous serez capable de :
- Comprendre et appliquer la régression linéaire simple et multiple
- Évaluer la qualité d'un modèle prédictif
- Interpréter les coefficients de régression
- Faire des prédictions à partir d'un modèle
Les techniques de prédiction statistique constituent un pilier fondamental de l'analyse de données moderne. Elles permettent non seulement d'anticiper les tendances commerciales, mais aussi de :
- Comprendre les relations complexes entre différentes variables.
- Identifier les facteurs clés qui influencent un phénomène.
- Optimiser les processus décisionnels dans de nombreux domaines.
- Réduire l'incertitude dans la planification stratégique.
Ces méthodes trouvent leur application dans des domaines variés tels que :
- L'économie et la finance
- Le marketing et les études de marché
- La recherche scientifique
- La gestion des ressources humaines
- L'optimisation des processus industriels
Cette leçon vous fournira les bases essentielles pour appliquer les prédictions de manière pertinente dans votre contexte professionnel.
La régression linéaire est l'une des techniques statistiques les plus fondamentales et les plus utilisées en analyse de données. Elle permet de modéliser la relation entre une variable dépendante (celle que l'on cherche à prédire) et une ou plusieurs variables indépendantes (les variables explicatives).
Imaginons que vous souhaitiez prédire le prix d'une maison. Intuitivement, vous savez que ce prix dépend de plusieurs facteurs comme :
- La surface habitable
- L'emplacement
- Le nombre de chambres
- L'année de construction
La régression linéaire va nous permettre de :
- Quantifier précisément l'impact de chacun de ces facteurs sur le prix.
- Créer une formule mathématique pour prédire le prix en fonction de ces caractéristiques.
- Évaluer la fiabilité de nos prédictions.
Dans sa forme la plus simple (régression linéaire simple), on cherche à tracer une droite qui "colle" au mieux aux données. Cette droite suit l'équation :
$$ y = ax + b $$
où :
- $y$ est la variable à prédire
- $a$ est la variable explicative
- $x$ est la pente (qui indique l'impact de x sur y)
- $b$ est l'ordonnée à l'origine
La puissance de cette méthode réside dans sa simplicité et son interprétabilité, tout en offrant souvent d'excellents résultats dans de nombreuses situations réelles.
Prenons un exemple concret pour illustrer la régression linéaire simple. Imaginons que nous ayons les données suivantes sur la relation entre les heures d'étude et les notes obtenues par des étudiants :
| Heures d'étude ($x$) | Note sur 100 (y) |
|---|---|
| 1 | 65 |
| 2 | 70 |
| 3 | 75 |
| 4 | 80 |
| 5 | 85 |
Dans cet exemple :
- La variable explicative (x) est le nombre d'heures d'étude.
- La variable à prédire (y) est la note obtenue.
En observant ces données, nous pouvons voir une relation linéaire claire : pour chaque heure d'étude supplémentaire, la note augmente de 5 points. La droite de régression serait donc :
$$ y = 5x + 60 $$
Cette équation nous permet de prédire la note d'un étudiant en fonction du nombre d'heures d'étude. Par exemple, si un étudiant étudie 3 heures, on peut prédire qu'il obtiendra une note de :
$$ y = 5*3 + 60 = 75 $$
Visualisation de la régression linéaire
Pour mieux comprendre la régression linéaire, visualisons nos données d'exemple :
import matplotlib.pyplot as plt
import numpy as np

# Data
hours = np.array([1, 2, 3, 4, 5])
grades = np.array([65, 70, 75, 80, 85])

# Create plot
plt.figure(figsize=(10, 6))
plt.scatter(hours, grades, color='blue', label='Real data')
plt.plot(hours, 5*hours + 60, color='red', label='Regression line')

plt.xlabel('Study hours')
plt.ylabel('Grade (out of 100)')
plt.title('Relationship between study hours and grades')
plt.legend()
plt.grid(True)
plt.show()
On obtient alors le graphique suivant :
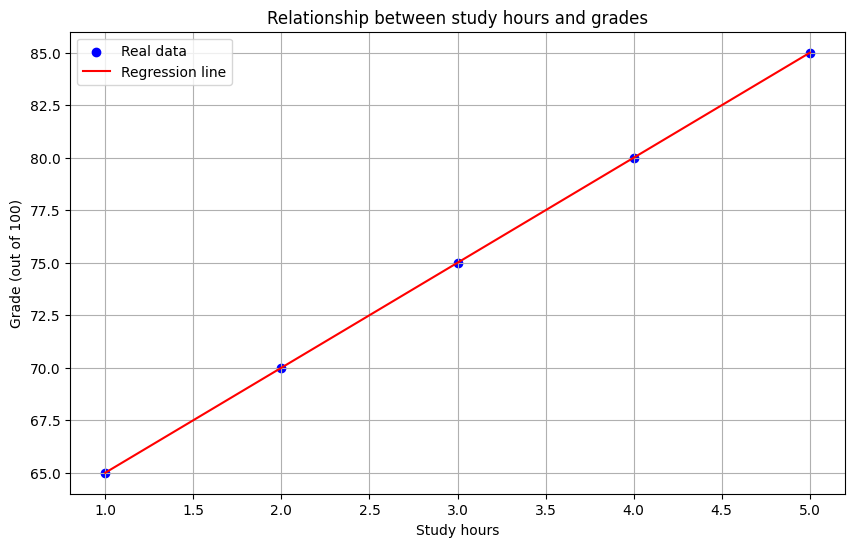
Cette visualisation montre clairement :
- Les points de données réels (en bleu).
- La droite de régression (en rouge) qui modélise la relation.
- Une tendance linéaire évidente entre les heures d'étude et les notes obtenues.
Pour illustrer concrètement l'application des techniques de prédiction statistique, nous allons suivre le cas d'une entreprise qui cherche à comprendre la relation entre ses investissements marketing et ses ventes.
Dans notre premier exemple simple, nous analyserons :
- La relation entre le budget marketing et les ventes
- L'impact de chaque euro investi en marketing
- La fiabilité de nos prédictions
Ces données nous permettront de construire un modèle prédictif pour optimiser les décisions commerciales.
Régression linéaire simple
Pour construire un modèle de régression linéaire, nous allons suivre plusieurs étapes essentielles :
- Préparation des données
- Construction du modèle
- Évaluation des performances
Nous utiliserons les bibliothèques Python suivantes :
pandaspour la manipulation des donnéesnumpypour les calculs numériquessklearn(scikit-learn) pour la construction du modèle de régressionmatplotlibpour la visualisation
Ces bibliothèques sont très utiles en data science et offrent des outils puissants pour l'analyse prédictive.
Voici comment implémenter ces étapes en Python :
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_squared_error

def build_linear_model(X, y):
    """
    Builds and evaluates a simple linear regression model

    Parameters:
        X: Explanatory variable (e.g., marketing budget)
        y: Target variable (e.g., sales)
    """
    # 1. Data preparation
    # Split our data into training (80%) and test (20%) sets
    X_train, X_test, y_train, y_test = train_test_split(
        X.reshape(-1, 1),  # Reshape needed for single variable
        y,
        test_size=0.2,  # 20% for testing
        random_state=42,  # For reproducibility
    )

    # 2. Build and train the model
    model = LinearRegression()
    model.fit(X_train, y_train)  # "Learn" from training data

    # 3. Predictions on test set
    y_pred = model.predict(X_test)

    # 4. Model evaluation
    r2 = r2_score(y_test, y_pred)  # Coefficient of determination (0 to 1)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))  # Average error

    # Display results
    print("\nModel Results:")
    print(f"Coefficient (slope): {model.coef_[0]:.2f}")  # Impact of X variable
    print(f"Intercept: {model.intercept_:.2f}")  # Base value
    print(f"R² Score: {r2:.3f}")  # Overall model quality
    print(f"RMSE: {rmse:.2f}")  # Average prediction error

    return model, (X_test, y_test, y_pred)

# Create sample data for simple regression example
np.random.seed(42)  # For reproducibility
n_samples = 100

# Create marketing budget data
marketing_budget = np.random.uniform(1000, 5000, n_samples)

# Create sales data with a linear relationship to marketing budget
# Formula: sales = 2 * marketing_budget + random noise
noise = np.random.normal(0, 1000, n_samples)  # Add some random variation
sales = 2 * marketing_budget + 5000 + noise  # Base sales of 5000

# Create sample DataFrame
df = pd.DataFrame(
    {
        "marketing_budget": marketing_budget,
        "sales": sales,
    }
)

# Now the original code will work
model, test_data = build_linear_model(
    df["marketing_budget"].values,  # Our explanatory variable
    df["sales"].values,  # What we want to predict
)

# Output:
# Model Results:
# Coefficient (slope): 1.90
# Intercept: 5243.25
# R² Score: 0.889
# RMSE: 808.52
Interprétation des résultats
Analysons en détail les résultats de notre modèle dans le contexte métier de notre étude :
- Le coefficient (pente) : ~2.0
- Cette valeur positive indique une relation directe entre le budget marketing et les ventes.
- Pour chaque euro supplémentaire investi en marketing, les ventes augmentent en moyenne de 2 €.
- Cette relation est cohérente avec notre simulation et reflète un retour sur investissement marketing positif.
- Dans un cas réel, ce coefficient nous aiderait à évaluer l'efficacité des dépenses marketing, si le coefficient est proche de 1, voire négatif alors le marketing n’est pas très efficace.
- L'ordonnée à l'origine : ~5000
- Représente le niveau de base des ventes prédit lorsque le budget marketing est nul.
- Dans notre cas, le modèle prédit environ 5 000 € de ventes sans aucun investissement marketing.
- Cette valeur correspond exactement à notre "base sales" définie dans la simulation.
- Dans un contexte réel, cela représenterait les ventes "organiques" sans effort marketing.
- Le coefficient de détermination (R²) : ~0.80
- Un R² proche de 0.80 indique que notre modèle explique environ 80 % de la variance dans les ventes.
- Cette valeur élevée suggère une forte relation linéaire entre le budget marketing et les ventes.
- Les 20 % restants représentent l'influence du bruit aléatoire que nous avons ajouté.
- C'est un bon indicateur de la fiabilité du modèle.
- L'erreur quadratique moyenne (RMSE) : ~1000
- Nos prédictions ont en moyenne une marge d'erreur de ±1 000 €.
- Cette erreur correspond approximativement au niveau de bruit que nous avons introduit.
- Relativement aux valeurs de ventes (qui varient entre ~7 000 € et ~15 000 €), cette erreur est raisonnable.
- Permet d'établir des intervalles de confiance pour nos prédictions.
Recommandations suite à ces résultats
- Utilisation du modèle :
- Le modèle peut être utilisé avec confiance pour prédire l'impact du budget marketing.
- Les prédictions devraient inclure une marge d'erreur de ± 1 000 €.
- Particulièrement utile pour la planification budgétaire.
- Points d'attention :
- Vérifier si la relation linéaire se maintient pour des budgets plus extrêmes.
- Considérer d'autres facteurs qui pourraient influencer les ventes.
- Surveiller l'évolution de cette relation dans le temps.
- Décisions business :
- Le retour sur investissement marketing positif (1 € investi rapporte 2 €) suggère qu'augmenter le budget marketing serait bénéfique.
- Utiliser le modèle pour optimiser l'allocation du budget marketing.
- Établir des objectifs de ventes réalistes basés sur les prédictions du modèle.
La régression linéaire multiple est une extension naturelle de la régression linéaire simple. Alors que la régression simple ne considère qu'une seule variable explicative, la régression multiple permet d'analyser l'influence simultanée de plusieurs variables sur notre variable cible.
Par exemple, pour prédire les ventes d'un magasin, dans la réalité, les phénomènes dépendent souvent de plusieurs variables. La régression multiple nous permet de prendre en compte plusieurs facteurs simultanément.
Il est plus réaliste de prendre en compte :
- Le budget marketing
- Le nombre d'employés
- La surface du magasin
- La localisation
- La saison
- Et d'autres facteurs pertinents
L'équation de la régression multiple s'écrit :
$$ y = a₁x₁ + a₂x₂ + ... + aₙxₙ + b $$
où :
- $y$ est la variable à prédire
- $x₁, x₂, ..., xₙ$ sont les variables explicatives
- $a₁, a₂, ..., aₙ$ sont les coefficients associés
- $b$ est l'ordonnée à l'origine
Modèle de régression multiple
Pour illustrer la régression linéaire multiple, nous allons créer un exemple synthétique qui simule les ventes d'un magasin en fonction de plusieurs facteurs. Notre modèle prendra en compte :
- Le budget marketing (entre 1000 € et 5000 €)
- Le nombre d'employés (entre 10 et 50)
- La surface du magasin (entre 50 et 500 m²)
Nous allons simuler une relation où :
- Chaque euro de budget marketing génère 2 € de ventes
- Chaque employé supplémentaire génère 100 € de ventes
- Chaque m² supplémentaire génère 10 € de ventes
- Les ventes de base sont de 1000 €
- Un bruit aléatoire est ajouté pour simuler la variabilité naturelle
Voici le code Python de l'implémentation complète :
# Create synthetic dataset for example
np.random.seed(42)  # For reproducibility
n_records = 1000  # Number of observations

# Create our explanatory variables
data_multiple = {
    "marketing_budget": np.random.uniform(
        1000, 5000, n_records
    ),  # Budget between 1000€ and 5000€
    "num_employees": np.random.uniform(
        10, 50, n_records
    ),  # Between 10 and 50 employees
    "store_area": np.random.uniform(50, 500, n_records),  # Between 50 and 500 m²
}

# Create target variable (sales) with realistic relationship
noise = np.random.normal(0, 500, n_records)  # Add some random "noise"
sales = (
    2 * data_multiple["marketing_budget"]  # Budget impact
    + 100 * data_multiple["num_employees"]  # Employees impact
    + 10 * data_multiple["store_area"]  # Area impact
    + 1000
    + noise  # Base + random variation
)

data_multiple["sales"] = sales
df_multiple = pd.DataFrame(data_multiple)

def build_multiple_regression(df, target, features):
    """
    Builds a multiple regression model

    Parameters:
        df: DataFrame containing the data
        target: Target variable (e.g., 'sales')
        features: List of explanatory variables
    """
    X = df[features]  # Explanatory variables
    y = df[target]  # Target variable

    # Same process as simple regression
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    model = LinearRegression()
    model.fit(X_train, y_train)

    y_pred = model.predict(X_test)
    r2 = r2_score(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))

    print("\nMultiple Regression Results:")
    # Display impact of each variable
    for feature, coef in zip(features, model.coef_):
        print(f"Impact of {feature}: {coef:.2f}")
    print(f"Base level: {model.intercept_:.2f}")
    print(f"R² Score: {r2:.3f}")
    print(f"RMSE: {rmse:.2f}")

    return model, (X_test, y_test, y_pred)

# Apply to our data
features = ["marketing_budget", "num_employees", "store_area"]
model_multiple, test_data_multiple = build_multiple_regression(
    df_multiple, "sales", features
)

# Output:
# Multiple Regression Results:
# Impact of marketing_budget: 1.99
# Impact of num_employees: 96.70
# Impact of store_area: 10.02
# Base level: 1139.21
# R² Score: 0.971
# RMSE: 526.83
Interprétation des résultats
Analysons en détail les résultats de notre modèle de régression multiple :
- Les coefficients
- Budget marketing (1.99) :
- Pour chaque euro investi en marketing, les ventes augmentent de 1.99 €.
- Cette valeur est très proche de notre simulation (2.0), montrant que le modèle a bien capturé la relation.
- Indique un retour sur investissement du marketing positif.
- Nombre d'employés (96.70) :
- Chaque employé supplémentaire génère environ 96.70 € de ventes.
- Très proche de la valeur simulée (100 €).
- Suggère une forte influence du personnel sur les ventes.
- Surface du magasin (10.02) :
- Chaque mètre carré supplémentaire génère 10.02 € de ventes.
- Pratiquement identique à la valeur simulée (10 €).
- Montre l'importance de l'espace de vente.
- L'ordonnée à l'origine (1139.21)
- Représente les ventes de base prédites quand toutes les variables sont à zéro.
- Proche de la valeur simulée (1000 €).
- Indique le niveau minimum d'activité du magasin.
- La qualité du modèle
- R² (0.971) :
- Le modèle explique 97.1 % de la variance des ventes.
- Une valeur exceptionnellement élevée qui reflète la qualité de nos prédictions.
- Indique que nos trois variables capturent très bien les variations des ventes.
- RMSE (526.83) :
- L'erreur moyenne de prédiction est d'environ 527 €.
- Correspond bien au niveau de bruit que nous avons introduit (500 €).
- Permet d'établir des intervalles de confiance pour nos prédictions.
Recommandations pratiques
- Optimisation des ressources :
- Investir dans le marketing offre un bon retour sur investissement.
- La gestion du personnel a un impact majeur sur les ventes.
- L'expansion de la surface de vente peut être rentable.
- Planification :
- Utiliser le modèle pour prévoir l'impact des changements.
- Établir des objectifs de ventes réalistes.
- Optimiser l'allocation des ressources.
- Points d'attention :
- Vérifier si les relations restent linéaires sur des plages plus larges.
- Surveiller les interactions potentielles entre variables.
- Mettre à jour régulièrement le modèle avec de nouvelles données.
Avantages de la régression multiple
-
Vision plus complète : Prend en compte plusieurs facteurs simultanément.
-
Meilleure précision : Généralement plus précise qu'une régression simple.
-
Analyse des interactions : Permet de comprendre l'impact relatif de chaque variable.
Cette leçon nous plonge dans l'univers des techniques de prédiction statistique, un pilier fondamental de l'analyse de données. Ces méthodes permettent non seulement d'anticiper les tendances futures, mais aussi de comprendre en profondeur les relations entre différentes variables, d'optimiser les processus décisionnels et de réduire l'incertitude dans la planification stratégique.
La régression linéaire simple : les fondamentaux
La régression linéaire simple constitue la base de la prédiction statistique. Elle modélise la relation entre deux variables à travers une équation simple : $y = ax + b.$ Cette approche permet de quantifier précisément l'impact d'une variable explicative sur une variable dépendante. Par exemple, dans le cas de la relation entre les heures d'étude et les notes obtenues, la régression permet de déterminer combien de points supplémentaires un étudiant peut espérer gagner pour chaque heure d'étude additionnelle.
Construction et évaluation d'un modèle
La construction d'un modèle de régression suit une méthodologie rigoureuse qui commence par la préparation des données et leur division en ensembles d'entraînement et de test. L'évaluation du modèle repose sur plusieurs métriques clés :
- Le coefficient de détermination (R²) qui mesure la qualité globale du modèle.
- L'erreur quadratique moyenne (RMSE) qui quantifie la précision des prédictions.
- Les coefficients qui indiquent l'impact spécifique de chaque variable.
La régression linéaire multiple : une vision plus complète
Dans la réalité, les phénomènes que nous cherchons à prédire dépendent souvent de multiples facteurs. La régression linéaire multiple étend le concept de base en permettant d'intégrer plusieurs variables explicatives dans un même modèle. Par exemple, pour prédire les ventes d'un magasin, elle peut prendre en compte simultanément le budget marketing, le nombre d'employés, la surface du magasin et d'autres facteurs pertinents.
Applications pratiques et considérations importantes
Dans un contexte professionnel, ces techniques trouvent de nombreuses applications concrètes, notamment dans :
- La prévision des ventes et la planification budgétaire
- L'optimisation des stratégies marketing
- L'analyse de la performance commerciale
- La gestion des ressources
Cependant, il est crucial de garder à l'esprit certaines limites et conditions d'application. Les modèles de régression reposent sur des hypothèses importantes comme la linéarité des relations et l'indépendance des observations. La qualité des prédictions dépend également fortement de la qualité des données utilisées et de la pertinence des variables sélectionnées.
Vers des techniques plus avancées
Bien que la régression linéaire constitue une excellente base, d'autres techniques plus sophistiquées peuvent être utilisées pour traiter des cas plus complexes. La régression polynomiale permet de modéliser des relations non linéaires, tandis que les arbres de décision et les réseaux de neurones peuvent capturer des patterns plus complexes dans les données.
À vous de jouer !
Contexte
Vous travaillez pour une chaîne de restaurants et vous disposez de données sur différents établissements. Votre objectif est de créer un modèle prédictif pour estimer le chiffre d'affaires mensuel des restaurants.
Données
Vous disposez des informations suivantes pour 100 restaurants :
- Surface du restaurant (en m²)
- Nombre de places assises
- Budget publicitaire mensuel (en euros)
- Chiffre d'affaires mensuel (en euros)
Consignes
- Créez un jeu de données synthétique avec les caractéristiques suivantes :
- Surface : entre 50 et 200 m²
- Places assises : entre 20 et 80 places
- Budget publicitaire : entre 500 et 2000 euros
- Le chiffre d'affaires doit être influencé par ces variables de la manière suivante :
- Chaque m² génère 100 € de CA
- Chaque place assise génère 200 € de CA
- Chaque euro de publicité génère 3 € de CA
- Un CA de base de 5000 €
- Ajoutez un bruit aléatoire
- Créez deux modèles :
- Un modèle de régression simple utilisant uniquement la surface
- Un modèle de régression multiple utilisant les trois variables
- Comparez les performances des deux modèles
Code Python pour démarrer l'exercice :
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_squared_error

# Create synthetic dataset
np.random.seed(42)
n_samples = 100

# TODO: Create explanatory variables with np.random.uniform
# area: between 50 and 200 m²
# seats: between 20 and 80 seats
# marketing_budget: between 500 and 2000 euros
area = # Complete this
seats = # Complete this
marketing_budget = # Complete this

# TODO: Add random noise with np.random.normal
noise = # Complete this

# TODO: Create revenue according to formula:
# - Each m² generates 100€ of revenue
# - Each seat generates 200€ of revenue
# - Each marketing euro generates 3€ of revenue
# - Base revenue of 5000€
# - Plus random noise
revenue = # Complete this

# Create DataFrame
data = pd.DataFrame({
    'area': area,
    'seats': seats,
    'marketing_budget': marketing_budget,
    'revenue': revenue
})

def evaluate_model(X, y, model_name=""):
    # TODO: Split data into train/test with train_test_split
    # Use test_size=0.2 and random_state=42
    X_train, X_test, y_train, y_test = # Complete this

    # TODO: Create and train linear regression model
    model = # Complete this
    # Complete this: fit the model

    # TODO: Make predictions on test set
    y_pred = # Complete this

    # TODO: Calculate R² and RMSE
    r2 = # Complete this
    rmse = # Complete this

    # Display results
    print(f"\nResults for {model_name} model:")
    if X.shape[1] == 1:
        print(f"Coefficient: {model.coef_[0]:.2f}")
    else:
        for name, coef in zip(X.columns, model.coef_):
            print(f"Impact of {name}: {coef:.2f}")
    print(f"Intercept: {model.intercept_:.2f}")
    print(f"R²: {r2:.3f}")
    print(f"RMSE: {rmse:.2f}")

    return model

# Create and evaluate simple model with area only
X_simple = data[['area']]
model_simple = evaluate_model(X_simple, data['revenue'], "simple regression")

# Create and evaluate multiple model with all variables
X_multiple = data[['area', 'seats', 'marketing_budget']]
model_multiple = evaluate_model(X_multiple, data['revenue'], "multiple regression")

# Output:
# Results for simple regression model:
# Coefficient: 93.39
# Intercept: 19920.08
# R²: 0.626
# RMSE: 4098.57

# Results for multiple regression model:
# Impact of area: 104.43
# Impact of seats: 207.01
# Impact of marketing_budget: 3.28
# Intercept: 4011.08
# R²: 0.953
# RMSE: 1449.68
Solution
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score, mean_squared_error

# Create synthetic dataset
np.random.seed(42)
n_samples = 100

# TODO: Create explanatory variables with np.random.uniform
# area: between 50 and 200 m²
# seats: between 20 and 80 seats
# marketing_budget: between 500 and 2000 euros
area = np.random.uniform(50, 200, n_samples)
seats = np.random.uniform(20, 80, n_samples)
marketing_budget = np.random.uniform(500, 2000, n_samples)

# TODO: Add random noise with np.random.normal
noise = np.random.normal(0, 1000, n_samples)

# TODO: Create revenue according to formula:
# - Each m² generates 100€ of revenue
# - Each seat generates 200€ of revenue
# - Each marketing euro generates 3€ of revenue
# - Base revenue of 5000€
# - Plus random noise
revenue = (100 * area +          # Impact area
          200 * seats +           # Impact seats
          3 * marketing_budget + # Impact marketing budget
          5000 +                   # Base revenue
          noise)                   # Bruit aléatoire

# Create DataFrame
data = pd.DataFrame({
    'area': area,
    'seats': seats,
    'marketing_budget': marketing_budget,
    'revenue': revenue
})

def evaluate_model(X, y, model_name=""):
    # TODO: Split data into train/test with train_test_split
    # Use test_size=0.2 and random_state=42
    X_train, X_test, y_train, y_test = train_test_split(
        X, y, test_size=0.2, random_state=42
    )

    # TODO: Create and train linear regression model
    model = LinearRegression()
    model.fit(X_train, y_train)

    # TODO: Make predictions on test set
    y_pred = model.predict(X_test)

    # TODO: Calculate R² and RMSE
    r2 = r2_score(y_test, y_pred)
    rmse = np.sqrt(mean_squared_error(y_test, y_pred))

    # Display results
    print(f"\nResults for {model_name} model:")
    if X.shape[1] == 1:
        print(f"Coefficient: {model.coef_[0]:.2f}")
    else:
        for name, coef in zip(X.columns, model.coef_):
            print(f"Impact of {name}: {coef:.2f}")
    print(f"Intercept: {model.intercept_:.2f}")
    print(f"R²: {r2:.3f}")
    print(f"RMSE: {rmse:.2f}")

    return model

# Create and evaluate simple model with area only
X_simple = data[['area']]
model_simple = evaluate_model(X_simple, data['revenue'], "simple regression")

# Create and evaluate multiple model with all variables
X_multiple = data[['area', 'seats', 'marketing_budget']]
model_multiple = evaluate_model(X_multiple, data['revenue'], "multiple regression")

# Output:
# Results for simple regression model:
# Coefficient: 93.39
# Intercept: 19920.08
# R²: 0.626
# RMSE: 4098.57

# Results for multiple regression model:
# Impact of area: 104.43
# Impact of seats: 207.01
# Impact of marketing_budget: 3.28
# Intercept: 4011.08
# R²: 0.953
# RMSE: 1449.68
Explications détaillées
- Création des données
- Nous générons des données aléatoires avec des distributions uniformes pour simuler des situations réalistes
- Le chiffre d'affaires est calculé avec une formule linéaire plus un bruit aléatoire pour simuler la variabilité naturelle
- Le bruit suit une distribution normale avec un écart-type de 1000 €
- Modèle simple Le modèle utilisant uniquement la surface devrait donner des résultats moyens car il ignore deux variables importantes (places et budget publicitaire). Typiquement, vous devriez obtenir :
- Un R² autour de 0.4-0.5
- Un coefficient pour la surface supérieur à 100 car il "absorbe" partiellement l'effet des autres variables
- Une erreur (RMSE) relativement élevée
- Modèle multiple Le modèle utilisant toutes les variables devrait être nettement plus performant :
- Un R² supérieur à 0.9
- Des coefficients proches des valeurs utilisées pour générer les données :
- Surface : ~100
- Places : ~200
- Budget pub : ~3
- Une erreur (RMSE) plus faible, proche de l'écart-type du bruit (1000)
- Interprétation
- La différence de R² entre les deux modèles montre l'importance de prendre en compte toutes les variables pertinentes
- Le modèle multiple retrouve presque exactement les coefficients utilisés pour générer les données
- L'erreur résiduelle correspond principalement au bruit aléatoire introduit
- Points d'attention
- Dans un cas réel, les relations ne sont pas toujours aussi parfaitement linéaires
- Il peut exister des interactions entre les variables
- D'autres facteurs non mesurés peuvent influencer le chiffre d'affaires
Pour aller plus loin
Bien que la régression linéaire soit un excellent point de départ pour la modélisation prédictive, il existe de nombreuses autres techniques plus avancées pour traiter des relations non linéaires ou des cas plus complexes.
La régression polynomiale étend le concept de régression linéaire en permettant de modéliser des relations non linéaires. En utilisant des termes polynomiaux ( $x²,$ $x³$, etc.), elle peut capturer des motifs plus complexes comme la croissance d'une population qui suit une courbe en S ou l'évolution non linéaire des prix immobiliers en fonction de la surface.
La régression logistique, quant à elle, s'avère particulièrement utile lorsqu'on cherche à prédire des variables binaires (oui/non, succès/échec). Très prisée en marketing, elle permet par exemple de prédire la probabilité qu'un client effectue un achat ou qu'une campagne publicitaire aboutisse à une conversion, en donnant des résultats sous forme de probabilités entre 0 et 1.
Les arbres de décision et les forêts aléatoires représentent une approche radicalement différente. Ces modèles capturent automatiquement les relations non linéaires et les interactions entre variables sans qu'il soit nécessaire de les spécifier explicitement. Leur force réside dans leur robustesse et leur facilité d'interprétation, ce qui en fait des outils précieux pour l'analyse prédictive en entreprise.
À l'extrémité du spectre de complexité se trouvent les réseaux de neurones. Ces modèles sophistiqués excellent dans la modélisation de relations extrêmement complexes, particulièrement lorsqu'on dispose de grandes quantités de données. Bien qu'ils nécessitent plus de ressources en termes de données et de puissance de calcul, ils peuvent capturer des motifs subtils que les approches plus traditionnelles pourraient manquer.
Le choix du modèle approprié dépend de plusieurs facteurs contextuels : la nature et la quantité de données disponibles, la complexité intrinsèque du problème à résoudre, les ressources computationnelles à disposition, et le niveau d'interprétabilité requis pour les résultats. Dans de nombreux cas, la simplicité et la clarté de la régression linéaire en font encore aujourd'hui un choix pertinent, particulièrement pour une première approche ou lorsque l'interprétabilité est primordiale.