Spring Data JPA 1 : Hibernate
À savoir avant de commencer
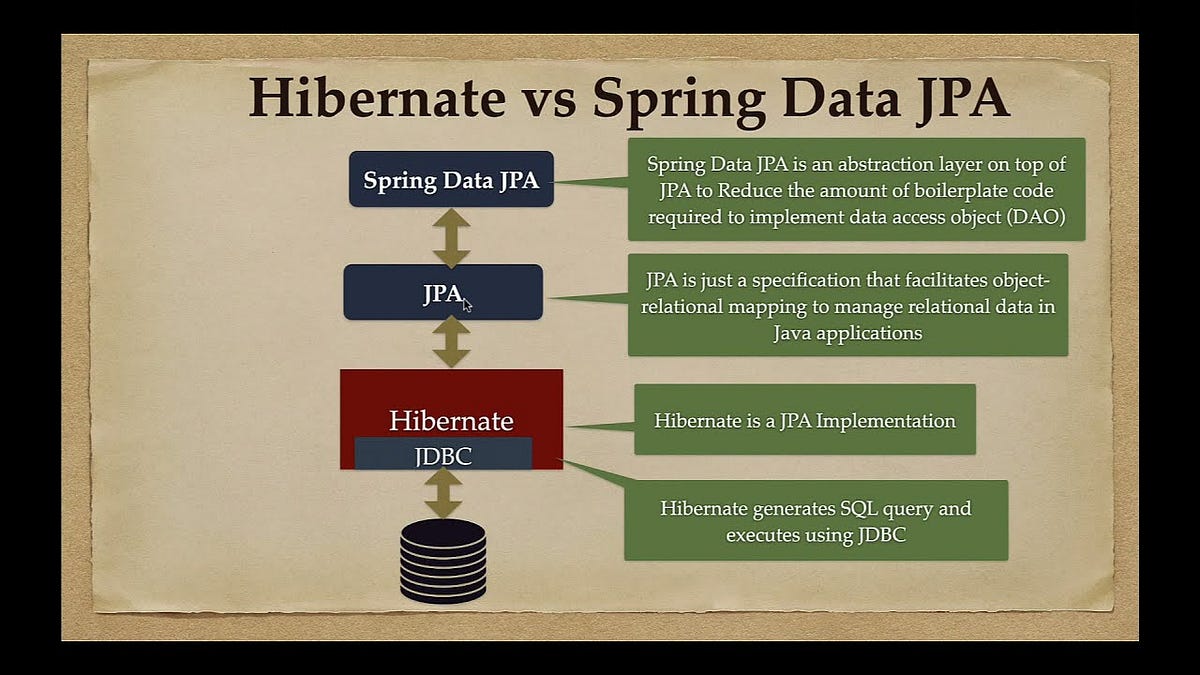
- JPA (Java Persistence Api) est un ensemble de normes servant à définir les modalités de fonctionnement d'un ORM.
- Un ORM permet aux développeurs de manipuler les données de la base de données comme s'ils manipulaient des objets dans leur langage de programmation. Au lieu d'écrire des requêtes SQL pour interagir avec la base de données, les développeurs peuvent utiliser les méthodes et les objets de leur langage de programmation, ce qui peut augmenter significativement la productivité et la lisibilité du code.
- L'ORM que nous allons utilisé s'appelle Hibernate qui est une implémentation de la spécification JPA.
- Spring Data JPA est le module disponible sous spring qui lui même est une surcouche de Hibernate permettant de simplifier encore plus la gestion de base de données directement depuis le code java. Bien sûr, pour certains cas de figure, nous devrons quand même remettre les mains sous le capot et définir certaines requêtes en SQL natif.
- @Controller, cela permet de créer une API Rest (Un ensemble de route qui vont nous renvoyer des données spécifiques). Ce n'est pas grave si tu ne comprend pas pour l'instant, tout te sera expliqué en détails un peu plus tard jeune padawan.
Dans cette quête, tu vas apprendre à créer une application Spring rudimentaire connectée à une base de données MySQL. Nous utiliserons Hibernate (et Spring Data JPA - pas de panique si le terme ne te dit rien pour l'instant, c'est normal).
Objectifs
- Comprendre le principe de Spring Data JPA et Hibernate
- Savoir configurer un projet Spring Boot pour le lier à une base de données
Un peu de théorie

Comme tu le sais déjà, Java est un langage orienté objet, c'est-à-dire que toutes les données sont stockées dans des objets. Une application Spring étant avant tout une application Java, le même principe s'applique pour elle. Une base de données (BDD), elle, stocke les données dans des tables.
Pour que les données transitent sans encombres entre ton application Spring et ta base de données, il est donc nécessaire d'établir des correspondances (mapping) entre les données de tes objets et les données de tes tables.
Ce serait quand même pratique si on pouvait automatiser tout ça, non ?
Exact ! C'est justement pour cela qu'a été créée la spécification Java Persistence API (JPA de son petit nom). En elle-même, JPA ne fournit aucune implémentation (aucun code concret), juste des normes à respecter, sous forme d'interfaces.
Ces interfaces sont concrètement implémentées par de nombreuses solutions. Dans cette quête, tu manipuleras : Spring Data JPA, qui implémente JPA avec Hibernate.
Hibernate est une solution d'Object-Relational Mapping (ORM), c'est-à-dire un programme qui joue le rôle d'intermédiaire entre ton application et ta base de données (tu trouveras plus d'informations en ressources).
Jusqu'à présent tu avais créé les tables de ta base à partir de requêtes SQL. Maintenant tout sera fait avec Spring Data JPA : les tables seront créées à partir des entités.
Attention à ne pas faire d'amalgame !
Pour en savoir plus sur comment on est passé de JDBC à JPA, lis cet article jusqu'à la partie Step-by-step Code example.
Configurer son projet
1. Initialisation
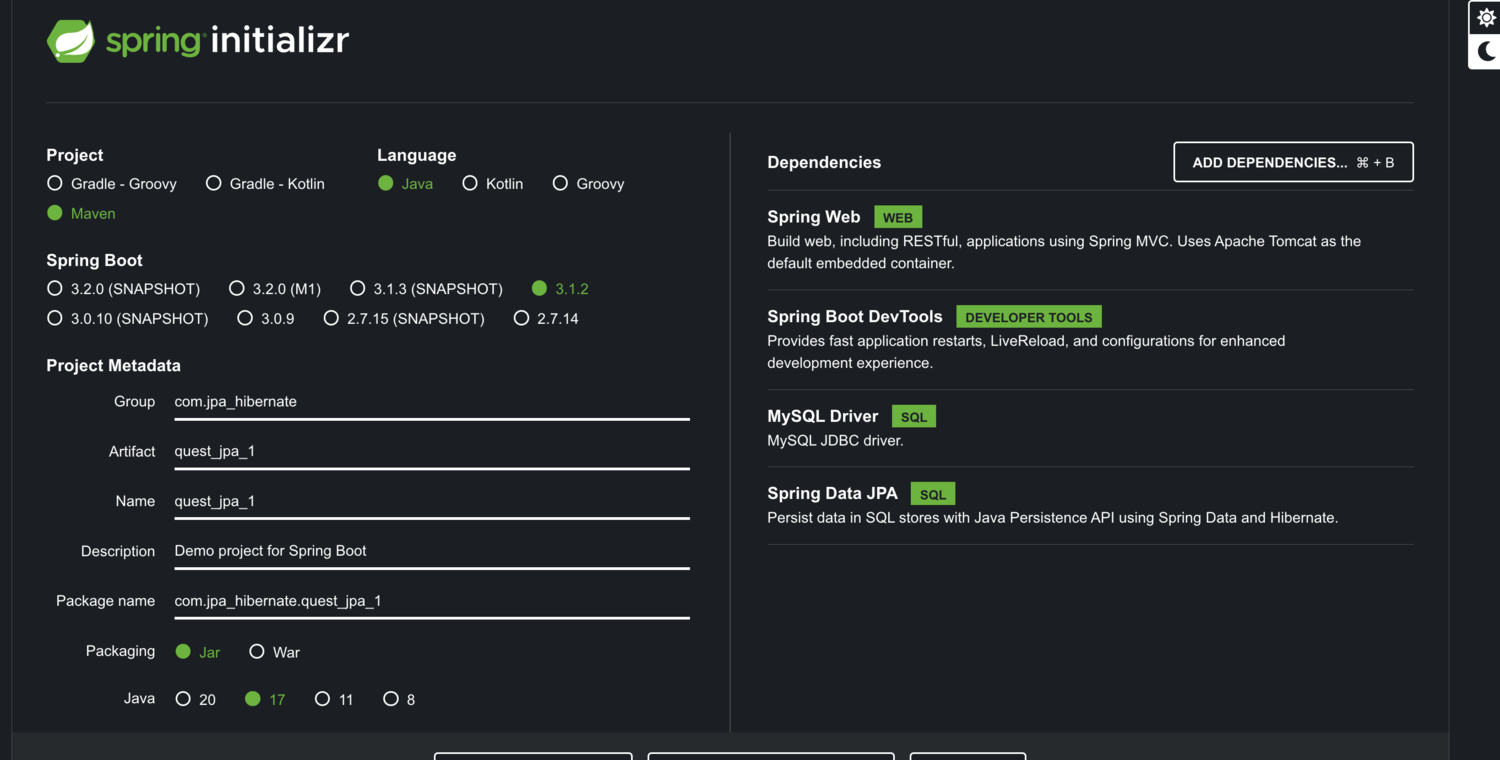
Pour créer un projet utilisant la bibliothèque, rends-toi sur https://start.spring.io/ et dans les dependencies, sélectionne Spring Web, Spring Data JPA et MySQL Driver et Spring Boot DevTools.
2. Base de données
Pour que le code présenté ci-dessous fonctionne, il te faudra créer la base de données spring_jpa_quest.
CREATE DATABASE IF NOT EXISTS `spring_jpa_quest`;
De plus, un utilisateur avec l'identifiant ton_username_perso et le mot de passe ton_mdp_perso devra exister, avec les droits en lecture et écriture sur la base de données spring_jpa_quest.
CREATE USER 'ton_username_perso'@'localhost' IDENTIFIED WITH mysql_native_password BY 'ton_mdp_perso';
GRANT ALL PRIVILEGES ON `spring_jpa_quest`.* TO 'ton_username_perso'@'localhost';
FLUSH PRIVILEGES;
3. Configuration
Afin de configurer la connexion à la base de données, il te faudra modifier le fichier application.properties dans le package src/main/resources.
C'est à cet endroit que tu vas renseigner les identifiants de connexions ainsi que les paramètres d'Hibernate.
# Informations sur la BDD à exploiter
spring.datasource.url=jdbc:mysql://localhost:3306/spring_jpa_quest
spring.datasource.username=ton_username_perso
spring.datasource.password=ton_mdp_perso

# Autoriser l'affichage des requêtes SQL faites par Hibernate
spring.jpa.show-sql=true

# Règle le fuseau horaire sur GMT+2
spring.jpa.properties.hibernate.jdbc.time_zone=Europe/Paris

# Gérer Hibernate
spring.jpa.hibernate.ddl-auto=update
Tout ce qui est détaillé dans ce fichier de configuration est plutôt compréhensible (car expliqué par des commentaires), sauf pour la section "Gérer Hibernate".
Tu remarque que la clef spring.jpa.hibernate.ddl-auto : c'est cette ligne qui va permettre à Spring Data JPA de créer la base de données à partir des entités.
Voici les valeurs possibles, ainsi que leurs utilisations respectives :
-
none: ne fait rien -
validate: au lancement, vérifie que la structure de base de données est valide (mais ne fait rien de plus) -
create: au lancement, crée la structure de la base de données, s'il n'existe pas déjà -
create-drop: au lancement, supprime toutes les tables et crée la structure de la base de données -
update: au lancement, met à jour la structure de la base de données si elle a changé et la crée si elle n'existe pas
Ici tu utiliseras update : la base sera ainsi créée et mise à jour lors des modifications des entités.
Pour information, répertorie toutes les (nombreuses) propriéties qu'on peut définir dans applications.properties.
Entity
Maintenant que la configuration est faite, passons au code !
:warning: En Spring Boot 3: le package des annotations JPA
javax.persistencea été transformée enjakarta.persistence
Pour commencer, voici un objet simple, que tu verras parfois nommé POJO (plain old Java object) qui représente un sorcier :
public class Wizard {

    private Long id;
    private String firstName;
    private String lastName;
    private Date birthday;
    private String birthPlace;
    private String biography;
    private boolean muggle;

    public Wizard(Long id, String firstName, String lastName, Date birthday, String birthPlace, String biography, boolean muggle) {
        this.id = id;
        this.firstName = firstName;
        this.lastName = lastName;
        this.birthday = birthday;
        this.birthPlace = birthPlace;
        this.biography = biography;
        this.muggle = muggle;
    }
}
Pour transformer cet objet en entité (entity), c'est-à-dire en quelque chose de convertissable en table de base de données, on va devoir y apporter quelques modifications :
@Entity
public class Wizard {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String firstName;
    private String lastName;
    private Date birthday;
    private String birthPlace;
    private String biography;
    private boolean muggle;

    public Wizard() {
    }

    // getters and setters omitted for brevity
}
Voici les informations obligatoires qu'une entité respectable se doit de posséder :
-
l'annotation
@Entity: elle indique que ton objet doit être géré par Spring Data et que ses attributs doivent être convertis en colonnes de tables de BDD. -
@Id: indique que l'attribut devra être utilisé en tant que clé primaire dans la table correspondante à l'entité. -
@GeneratedValue(strategy = GenerationType.IDENTITY): indique que la valeur de l'id sera générée automatiquement, par incrémentation, lors de l'insertion dans la base de données. Cette annotation peut prendre diverses valeurs (cf. ressources), selon ce dont tu as besoin. -
Un constructeur vide ainsi que les accesseurs (getters) et mutateurs (setters) : c'est grâce à eux qu'une instance de l'entité sera créée automatiquement par son repository.
Tu aurais pû ajouter un constructeur non vide, mais dans notre cas il ne sera plus utilisé : JPA créera une instance de Wizard grâce au constructeur vide et modifiera les valeurs avec les setters.
Note : l'IDE peut t'aider à trouver les packages de chaque élément
Pour faire notre pont, on va créer une interface WizardRepository, qui hérite d'une interface JpaRepository déjà existante dans Spring Data. Si tu vas consulter la documentation officielle de Spring (cf. ressources), tu verras que cette interface contient des signatures de méthodes correspondant à des opérations liées au CRUD (notamment save, delete, etc.). Puisque l'interface WizardRepository en est l'enfant, elle hérite de ses signatures de méthodes.
@Repository
public interface WizardRepository extends JpaRepository<Wizard, Long> {
}
-
@Repositoryindique à Spring que cette classe est le lien entre notre application et la base de données (pour en savoir plus, va lire la ressource Spring Bean Annotations). -
Les paramètre
<Wizard, Long>signalent que notre interface sera chargée de gérer notre entitéWizard, et que l'identifiant unique deWizard(son id) est de typeLong.
Comme l'interface JpaRepository hérite dePagingAndSortingRepository, lui-même enfant de CrudRepository, cela signifie simplement qu'elle définit davantage de fonctionnalités que ses parents. C'est pour cela que WizardRepository est presque vide : tout ce dont tu as besoin est hérité !
Voici une partie du code de CrudRepository, pour que tu saches de quelles méthodes tu disposes :
public interface CrudRepository<T, ID> extends Repository<T, ID> {

    // Create and Update an entity
    <S extends T> S save(S var1);

    // Select one
    Optional<T> findById(ID var1);

    // Select all
    Iterable<T> findAll();

    // Delete
    void deleteById(ID var1);

    // other methods omitted for brevity
}
Comme tu peux le remarquer, excepté pour la méthode save qui a aussi le rôle de update.
Les interfaces, c'est bien joli, mais où est le code ? Le vrai, le concret, celui qui implémente les méthodes des interfaces ?
C'est ici que la magie de Spring Data JPA opère. En effet, c'est le framework qui va générer automatiquement une implémentation pour notre interface.

Oui, nous aussi ça nous a fait cet effet-là, la première fois qu'on en a entendu parler.
Au premier lancement du serveur, en regardant la console de Spring, tu découvriras que le texte suivant est apparu :
Hibernate: create table wizard (id bigint not null auto_increment, biography varchar(255), birth_place varchar(255), birthday date, first_name varchar(255), last_name varchar(255), muggle bit not null, primary key (id)) engine=InnoDB
Grâce à la configuration spring.jpa.hibernate.ddl-auto=update, le serveur a créé la table wizard à partir de l'entity correspondante !
Un article bien sympathique pour voir ou revoir les principales annotations utilisées dans Spring
CRUD
Commençons par initialiser notre contrôleur de CRUD :
@Controller
public class WizardController {

    private WizardRepository repository;

     public WizardController(WizardRepository wizardRepositoryToInject) {
       this.repository = wizardRepositoryToInject;
     }

    // TODO CRUD
}
Tu remarques la création d'une instance de WizardRepository par injection de dépendance dans le constructeur.
1. Read one
Si tu ajoutes la route affichant les informations d'un sorcier en particulier :
@GetMapping("/wizard")
public String getWizard(Model model,
                        @RequestParam(required = false) Long id) {

    Wizard wizard = new Wizard();
    if (id != null) {
        Optional<Wizard> optionalWizard = repository.findById(id);
        if (optionalWizard.isPresent()) {
            wizard = optionalWizard.get();
        }
    }
    model.addAttribute("wizard", wizard);

    return "wizard";
}
Il y a une différence notable avec le code que tu avais l'habitude de faire : l'utilisation des méthodes isPresent et get lors de l'appel de repository.findById(id).
La raison est la suivante : findById ne retourne pas un Wizard, mais un Optional<Wizard> ! La classe Optional "enveloppe" une classe et ajoute (entre autres) les méthodes suivantes :
-
isPresent: retourne vrai si un élément a bien été trouvé en base de données, faux sinon -
get: si un élément a bien été trouvé, retourne sa valeur, sinon lève une exception
Tu trouveras des informations supplémentaires sur la classe Optional en ressource.
Lors de l'affichage d'un sorcier, le texte suivant va apparaître dans la console de Spring :
Hibernate: select wizard.id, wizard.biography, wizard.birth_place, wizard.birthday, wizard.first_name, wizard.last_name, wizard.muggle from wizard where wizard.id=?
Il est possible que les champs et la table aient des alias, ici j'ai simplifié le texte pour plus de lisibilité
2. Read all
Si tu ajoutes la route affichant les informations de tous les sorciers :
@GetMapping("/wizards")
public String getAll(Model model) {

    model.addAttribute("wizards", repository.findAll());

    return "wizards";
}
Pas de différences avec ce que tu faisais jusqu'à présent.
Lors de l'affichage de la liste des sorciers, le texte suivant va apparaître dans la console de Spring :
Hibernate: select id, biography, birth_place, birthday, first_name, last_name, muggle from wizard
3. Create
Si tu ajoutes la route créant un nouveau sorcier :
@PostMapping("/wizard")
public String postWizard(@ModelAttribute Wizard wizard) {

    repository.save(wizard);
    return "redirect:/wizards";
}
Cela fonctionne comme avant : tu appelles la méthode save du repository puis tu redirige vers une page qui affiche la liste des sorciers.
En envoyant le formulaire de création d'un sorcier, le texte suivant va apparaître dans la console de Spring :
Hibernate: insert into wizard (biography, birth_place, birthday, first_name, last_name, muggle) values (?, ?, ?, ?, ?, ?)
4. Update
Sans le savoir, tu as déjà fait la route de mise à jour... C'est la même que celle de la création ! Revoyons le code :
@PostMapping("/wizard")
public String postWizard(@ModelAttribute Wizard wizard) {

    repository.save(wizard);
    return "redirect:/wizards";
}
Ici, nous avons deux cas pour Wizard wizard :
-
soit il possède un identifiant null et le sorcier est créé en base de données
-
soit il possède déjà un identifiant et les données du sorcier correspondant sont modifiées
En envoyant le formulaire de modification d'un sorcier, le texte suivant va apparaître dans la console de Spring :
Hibernate: update wizard set biography=?, birth_place=?, birthday=?, first_name=?, last_name=?, muggle=? where id=?
5. Delete
Si tu ajoutes la route supprimant un sorcier :
@GetMapping("/wizard/delete")
public String deleteWizard(@RequestParam Long id) {

    repository.deleteById(id);

    return "redirect:/wizards";
}
Pas de différences avec ce que tu faisais jusqu'à présent.
En supprimant le sorcier, le texte suivant va apparaître dans la console de Spring :
Hibernate: delete from wizard where id=?
Tu peux lire l'introduction et la section "Comment s’en servir ?"
Challenge
La magie de Spring Data JPA
Tu viens d'obtenir une mission de la part d'un grand groupe de Cinéma. Ton objectif est de crée une table contenant liste de films.
Chaque film sera composé d'un titre, d'une date de sortie, du nom de son acteur principale.
- Indiana Jones, 2023-06-14, Harisson Ford
- DeadPool, 2018-02-14, Ryan Reynolds
- Logan, 2017-05-19, Hugh Jackman
- 1
Step 1
Depuis ton terminal, connecte toi à mysql puis ensuite crée une base de données du nom de Cineco.
hiddenCliquer pour révéler mais essaye de t'en souvenir|||sql CREATE DATABASE IF NOT EXISTS `Cineco`; - 2
Step 2
Créer un utilisateur qui aura les droits sur la BD Cineco.
hiddenCliquer pour révéler mais essaye de t'en souvenir|||sql CREATE USER 'ton_username_perso'@'localhost' IDENTIFIED WITH mysql_native_password BY 'ton_mdp_perso'; GRANT ALL PRIVILEGES ON `Cineco`.* TO 'ton_username_perso'@'localhost'; FLUSH PRIVILEGES; - 3
Step 3
Connect toi avec le nouveau user que tu viens de créer et accède à la base de données Cineco. Tu pourra y voir les nouvelles données après la configuration de ton projet Spring boot.
- 4
Step 4
Créer un projet Spring Boot à l'aide de Spring Initializr en reprenant les dépendances listé sur l'image au début de la quête.
- 5
Step 5
Ajouter dans le fichier application.properties le code suivant, avec tes identifiants perso bien sûr, lis bien le fichier:
consolespring.datasource.url=jdbc:mysql://localhost:3306/Cineco Ceux de l'utilisateur que tu viens de créer spring.datasource.username=ton_username_perso spring.datasource.password=ton_mdp_perso Autoriser l'affichage des requêtes SQL faites par Hibernate spring.jpa.show-sql=true Règle le fuseau horaire sur GMT+2 spring.jpa.properties.hibernate.jdbc.time_zone=Europe/Paris Gérer Hibernate spring.jpa.hibernate.ddl-auto=updateCela te permettra de connecter ton serveur spring à ta base de données que tu aura créer dans ta console sql.
- 6
Step 6
- Crée une classe Film qui servira d'entité pour tes films. Ajoute-lui les attributs titre, acteur principal et date de sortie. Ainsi qu'un constructeur qui initialise ces attributs, sans oublier les getters et setters.
- Crée un repository pour faire le pont entre ta BD et ton application spring. (:u[Voir au niveau de WizarRepository dans la quête pour un exemple])
- 7
Step 7
Ajouter ce code dans le corps de ta main class, c'est la classe qui lance le process de spring boot. C'est celle qui possède cette annotation:@SpringBootApplication. Ainsi tu pourra vérifier ta BD sql pour y avoir tes 3 films si tu as bien tout configurer.
javaprivate FilmRepository repository; public QuestJpa1Application(FilmRepository filmRepository) { this.repository = filmRepository; } @Bean public CommandLineRunner demo() { return (args) -> { Film filmIndiana = new Film("Indiana Jones", "Harrison Ford", "2023-06-14"); Film deadPool = new Film("DeadPool", "Ryan Reynolds", "2018-02-14"); Film logan = new Film("Logan", "Hugh Jackman", "2017-05-19"); repository.save(filmIndiana); repository.save(deadPool); repository.save(logan); }; } - 8
Step 8: Solution si tu as finis
Critères de validation
- Le projet s'exécute bien et la base de données contient une table Film avec les champs correspondant au titre, la date de sortie et le nom de l'acteur principale.
- Vous avez crée un dépôt et il est accessible sur github.
Ressources partagées sur cette quête
- Lors du lancement de mon serveur, le build n'a pas fonctionné. Il s'avère que dans la quête, il y a des commentaires au sein du fichier applications.properties, et cela n'est pas apprécié par l'outil... Retirez-les et tout fonctionnera correctement !https://github.com/spring-projects/spring-boot/issues/24346
- Lors du lancement du serveur ça n'a pas non plus fonctionné, j'ai dû rajouter la solution "allowPublicKeyRetrieval=true" et "useSSL=false" à la datasource.url, comme proposé sur ce lien.https://stackoverflow.com/questions/50379839/connection-java-mysql-public-key-retrieval-is-not-allowed