0. Introduction communication en réseau
Après cette quête, tu comprendras la notion de protocole
Objectifs
- Aborder la notion de communication réseau
- Comprendre la notion de protocole de communication
- Comprendre l'utilisation du protocole HTTP
- Comprendre la structure d'une URL
Une bouteille à la mer
Plusieurs bateaux ont besoin de communiquer pendant leur voyage. Un moyen est à leur disposition, une bouteille à la mer. Le principe est d'écrire un message que l'on enferme dans une bouteille, la bouteille est jetée à la mer puis elle dérive jusqu'à ce qu'elle atteigne une côte. Certains des messages contenus sont retrouvés plusieurs décennies après avoir été jetés à la mer. L'auteur d'un message croise les doigts pour que le courant le pousse du bon côté et qu'il soit retrouvé à temps pour être lu en temps et en heure.
Toi, aspirant pirate, tu vas apprendre à délivrer de tels messages sur l'océan. Tu vas devoir apprendre à communiquer avec tes semblables d'une manière claire et compréhensible. Tu devras comprendre les mécanismes mis en oeuvre pour communiquer avec tes pairs. Comprendre les processus de communication en détail n'est pas une paire de manches, alors on va commencer petit et étudier les bases.
C'est parti !
Architecture client/serveur
Lorsqu'une communication est entamée entre deux pirates, une personne envoie la bouteille et l'autre la reçoit, puis répond. Il y a toujours un initiateur lors d'une communication, qui adresse une requête à l'autre. Une fois la requête adressée, l'interlocuteur la traite pour pouvoir y répondre. Le même système régit les communications sur les réseaux informatiques : un élément sur le réseau (un ordinateur, un switch, un routeur ...) exprime une requête à un autre élément, qui y répond si la requête est compréhensible.
Au lieu de parler d'interlocuteurs, en informatique, on parle de client et de serveur. Le client est à l'initiative de la communication en adressant une requête au serveur. Le serveur y répond correctement s'il comprend la requête, et exprime son désarroi lorsque le client formule du charabia. Les communications en informatique suivent des règles, tout comme celles de notre langage. Les règles sont bien moins riches et beaucoup plus rigoureuses que celles des communications humaines. Dans une architecture client/serveur, le serveur n'initialisera jamais une connexion vers un client ; il est le gardien du savoir reconnu par ses pairs et attend une prise de contact par eux. Il ne contactera au grand JAMAIS un client.
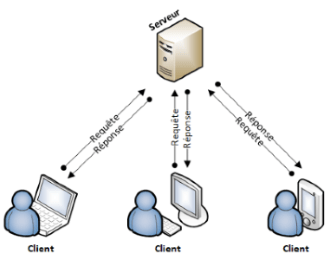
Il y a plusieurs architectures réseau, mais le modèle client/serveur est un des plus utilisés.
Mais comment client et serveur peuvent-ils communiquer ? Il y a bien une langue dans laquelle ils discutent entre eux, comme nous ?
Un langage pour se comprendre

Les communications dans le monde des pirates sont régies par un socle commun, qui permet à tous les protagonistes de se comprendre : un langage. Il en est de même pour les communications sur des équipements de réseau. Le monde de l'informatique regorge de langages, qui répondent chacun à un besoin particulier.
Mais les ordinateurs n'ont pas d'émotions, ils ne connaissent pas les nuances. Leurs circuits électroniques sont construits pour ne connaître que deux valeurs : vrai ou faux. On ne parle donc pas de langue entre équipements informatiques communiquant entre eux, mais de protocole. Les protocoles sont des manières de communiquer qui permettent à deux équipements informatiques d'entamer une discussion.
Tu utilises une plâtrée de protocoles quand tu surfes sur le Web. Il n'y en a qu'un seul que tu maîtrises, sans le savoir. Tu peux agir dessus, dans la barre en haut de ton navigateur.
De quel protocole s'agit-il ?
HyperText Transfer Protocol
Entre pirates, nous parlons plusieurs langages. Il en est de même pour les ordinateurs. Lorsqu'ils entament une discussion, ils utilisent un socle commun qui leur permet de se comprendre.
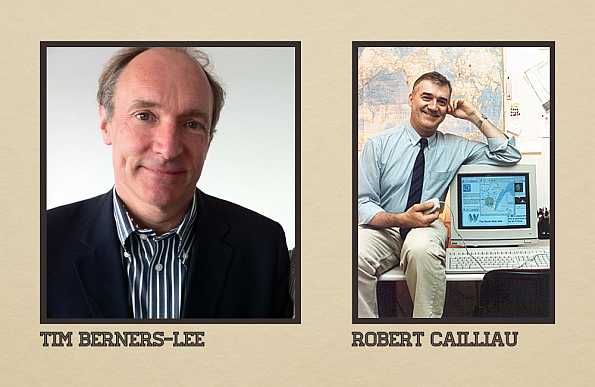
Le 6 août 1991, Tim Berners Lee (inventeur du Web) et Robert Cailliau publient une suite de solutions logicielles ayant pour but de créer un réseau de télécommunications massif. Ils proposent une manière simple de concevoir l'échange de données entre clients et serveurs. Dans cette suite logicielle est contenue la première version de HTTP qui est l'acronyme de HyperText Transfer Protocol. Il s'agit simplement d'un protocole d'échange de texte, rien de plus (du moins, à l'époque).
Traduit en français, HyperText Transfer Protocol veut dire protocole de transfert d'hypertexte. Ok pour le mot "protocole", ok pour le mot "transfert", mais l'hypertexte ? Un genre de texte augmenté ?
Eh oui ! L'hypertexte est en quelque sorte un "texte augmenté". Il s'agit simplement d'un ensemble de contenus textuels, reliés entre eux par des liens. Le concept d'hypertexte est une composante principale du World Wide Web tel qu'on le connaît aujourd'hui.
HTTP, 25 ans plus tard, est un standard du web et sans lui, nous n'aurions jamais découvert les merveilles que nous offre cette gigantesque bibliothèque qu'est l'Internet. HTTP est le langage avec lequel communiquent ton navigateur, ton routeur, ton téléphone ... Bref, tout ce qui a de près ou de loin trait à la récupération de texte sur la Toile.
Ok, les équipements discutent entre eux avec une langue, le web discute en HTTP principalement. Mais pour que les ordinateurs se reconnaissent entre eux, ils ont bien tous un nom, non ?
Un nom de domaine
Dans la réalité, chacune des personnes que tu croises a un nom. Lorsque tu l'appelles, elle répond. Elle se sent visée lorsque tu prononces son nom. Grâce à cela, tu peux discuter avec Marie et Georges et les deux ne se confondent pas. C'est la même chose entre les ordinateurs, ils se reconnaissent grâce à des noms.
Lorsque tu demandes une information à Google, tu es connecté à un des serveurs de Google. Un nom bien précis te permet de communiquer avec Google, il s'agit de son nom de domaine : google.com. Il en est de même pour Facebook. Son nom de domaine te permet de te connecter directement à l'un de ses serveurs, qui t'envoie ses pages. Le nom de domaine de Facebook est (roulement de tambours ...) facebook.com!
Il y a un protocole qui s'occupe d'associer des machines à un ou plusieurs noms de domaine, il s'agit du protocole DNS.
J'arrive donc à appeler un serveur avec son nom, mais comment puis-je lui demander quelque chose ?
Uniform Resource Locator
Un serveur met à disposition des ressources. Ces ressources peuvent être du texte, des images, de la musique et tout ce qui peut être disponible sur la Toile. L'Internet étant une immense bibliothèque, il faut bien la garder rangée pour retrouver les ressources. De ce fait, chaque ressource est rangée sur une étagère, étiquetée par un nom.

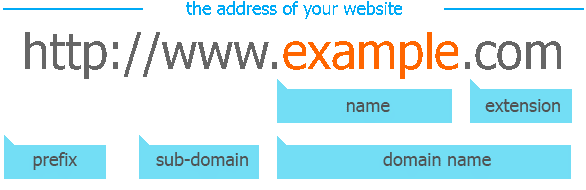
Lorsque tu navigues sur l'Internet, dans la barre en haut du navigateur, il y a quelque chose d'écrit. C’est l'URL, l'acronyme de Uniform Resource Locator. Il s'agit de l'étiquette de la ressource, de la route pour l'atteindre. L'URL est la route complète. C'est-à-dire qu'elle contient le nom de domaine et la route pour atteindre la ressource. Par exemple, ici un même sur les stagiaires en informatique : https://lesjoiesducode.fr/quand-jaccueille-le-stagiaire-pour-son-premier-jour.
Elle est composée du protocole utilisé (en l'occurrence HTTP), séparée par un double point et deux barres obliques (slashs), du nom de domaine puis du chemin à partir du nom de domaine pour accéder à la ressource.
Tu m'as parlé du nom de domaine et du protocole dans l'URL, mais n'as-tu pas oublié une partie ?
Regarder à partir de 4:12.
Uniform Resource Identifier
L'URI est le reste de l'URL, après le protocole et le nom de domaine. Il s'agit de l'endroit où est rangée l'information désirée. C'est le reste du chemin à parcourir une fois que tu es entré dans le serveur.
Par exemple l'URI de l'URL https://lesjoiesducode.fr/quand-jaccueille-le-stagiaire-pour-son-premier-jour est /quand-jaccueille-le-stagiaire-pour-son-premier-jour.
C'est bien beau, mais qui choisit pour nous comment vont communiquer les ordinateurs entre eux ?
Qui décrète tout ça ?
Les entreprises sont régies par des normes en fonction de leur secteur d'activité. La norme ISO 9001 est une norme de qualité, la norme SEPA est une norme de prélèvement/virement d'argent sur le territoire européen. Toutes ces normes sont discutées et créées par des organismes dédiés à cette tâche.
En informatique, c'est le même principe. Des organismes décident des standards, des normes, rédigent et valident des spécifications de protocoles de communication. Il y a beaucoup, beaucoup de standards qui régissent des domaines de l'informatique différents : le Web, la sécurité informatique, l'informatique embarquée, le réseau ...
Les protocoles de communication en particulier sont spécifiés en détail dans ce que l'on appelle les RFC, acronyme de Request For Comments. Ces documents contiennent tout ce qu'il faut savoir sur un protocole de communication standardisé. Le protocole HTTP dispose bien entendu de sa*RFC_, de même que le protocole **DNS__. Tous les protocoles standardisés doivent mettre à disposition une *RFC_ étudiée et mise en ligne par l'IETF.
Cependant les RFC sont des documents très techniques et il faut avoir le bagage nécessaire pour pouvoir comprendre ce qu'elles expliquent. Si tu veux pouvoir extraire des connaissances d'une RFC, tu auras besoin d'un anglais technique solide, de connaissances approfondies en réseaux informatiques, ainsi qu'une bonne dose de patience car certaines sont longues, trèèèès longues ...
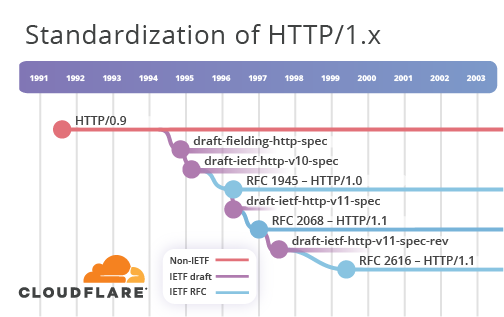
Certains protocoles ont plusieurs RFC, car ils ont évolué avec le temps. Le plus bel exemple est encore une fois le protocole HTTP :
La RFC 1035 qui traite du protocole DNS.
La RFC 7231 qui traite du protocole HTTP.
L'IETF est un organisme collaboratif ayant pour but de faire progresser les technologies de l'Internet.
ISO est un organisme international de standardisation dans divers secteurs.
ECMA est un organisme standardisant le secteur Européen de la technologie.
World Wide Web Consurtium s'occupe des normes sur le Web (ce sont notamment eux qui ont formulé les URL).
Challenge
Décomposer une URL
Prends une page internet et montre que tu sais identifier et séparer les parties les plus importantes d'une URL :
- Le protocole
- Le nom de domaine
- L'URI
Critères de validation
- Du texte suffira