Mesure de corrélation
Prérequis
Avant de plonger dans cette leçon, vous devriez être familier avec :
- Le travail avec les DataFrames Pandas
- Les statistiques descriptives de base
- Les concepts de base en visualisation de données
Objectifs pédagogiques
À la fin de cette leçon, vous serez capable de :
- Comprendre le concept de corrélation et ses différents types
- Calculer et interpréter les coefficients de corrélation
- Visualiser les relations entre variables
- Appliquer des techniques d'analyse de corrélation à des cas réels
L'analyse de corrélation est une technique statistique fondamentale qui permet d'évaluer la force et la direction de la relation entre deux variables. Cette compréhension est cruciale dans de nombreux domaines, de l'analyse financière à la recherche scientifique, en passant par le marketing et l'analyse de données commerciales.
L'analyse de corrélation est fondamentale en data science. Elle nous permet non seulement de comprendre les relations entre variables, mais aussi de :
- Identifier des opportunités commerciales.
- Détecter des problèmes potentiels.
- Guider la prise de décision basée sur les données.
- Valider des hypothèses métier.
La corrélation mesure la force et la direction de la relation entre deux variables. Le coefficient de corrélation est une valeur comprise entre -1 et 1 :
- Une corrélation de
1indique une relation positive parfaite. - Une corrélation de
-1indique une relation négative parfaite. - Une corrélation de
0indique l'absence de relation linéaire.
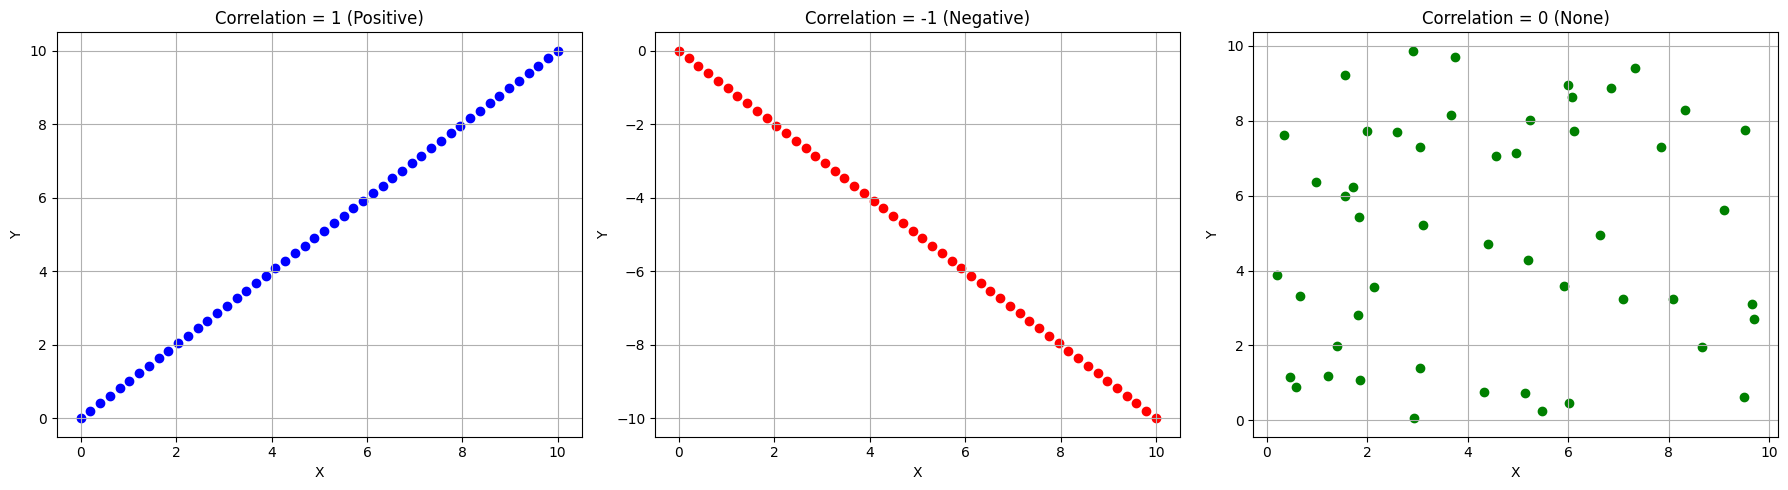
Explorons différents types de corrélation en utilisant un exemple de données de ventes :
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt

# Create sample data representing business metrics
data = {
    'price': [100, 120, 140, 160, 180, 200, 220, 240],          # Product price
    'sales': [500, 480, 460, 430, 410, 380, 360, 340],         # Units sold
    'marketing_budget': [1000, 1200, 1400, 1600, 1800, 2000, 2200, 2400],  # Marketing budget
    'customer_satisfaction': [4.2, 4.3, 4.1, 4.4, 4.3, 4.5, 4.6, 4.7]     # Customer satisfaction score
}

# Create DataFrame
df = pd.DataFrame(data)

# Display first rows to understand the data structure
print("Data overview:")
print(df.head())

# Output:
# Data overview:
#    price  sales  marketing_budget  customer_satisfaction
# 0   100     500              1000                  4.2
# 1   120     480              1200                  4.3
# 2   140     460              1400                  4.1
# 3   160     430              1600                  4.4
# 4   180     410              1800                  4.3
Dans cet exemple, le code illustre comment analyser les relations entre différentes métriques commerciales. En créant un DataFrame Data qui rassemble des données telles que le prix, les ventes, le budget marketing et la satisfaction client, il permet d'observer visuellement comment ces variables interagissent. Ainsi, on remarque :
- Une relation négative entre le prix et les ventes, indiquant qu’une augmentation du prix tend à entraîner une baisse des ventes.
- Une relation positive entre les dépenses marketing et la satisfaction client, suggérant que des investissements marketing plus élevés peuvent améliorer la satisfaction.
- Des variations non linéaires dans certaines relations, ce qui montre que l'interaction entre certaines variables n'est pas strictement proportionnelle.
Types de corrélation
La matrice de corrélation est un tableau statistique qui recense, pour chaque paire de variables d’un jeu de données, le coefficient de corrélation mesurant la force et la direction de leur relation linéaire. Chaque cellule de ce tableau contient une valeur comprise entre -1 (corrélation négative parfaite) et 1 (corrélation positive parfaite), avec les interprétations suivantes :
-
Corrélation positive : Se produit lorsque deux variables augmentent simultanément. Par exemple, une hausse des dépenses marketing est accompagnée d'une augmentation de la satisfaction client, indiquant que ces deux indicateurs évoluent dans le même sens.
-
Corrélation négative : Se manifeste lorsque l'augmentation d'une variable s'accompagne de la diminution de l'autre. Par exemple, une augmentation du prix tend à entraîner une baisse des ventes, illustrant une relation inverse entre ces deux mesures.
-
Absence de corrélation : Se traduit par une dispersion aléatoire des valeurs, sans qu’une tendance claire ne se dessine. Aucune relation linéaire n’est établie, et les variations des mesures ne se synchronisent pas.
# Calculate correlation matrix
correlation_matrix = df.corr()
print("\nCorrelation matrix:")
print(correlation_matrix)

# Output:
# Correlation matrix:
#                          price   sales  marketing_budget  customer_satisfaction
# price                  1.000000 -0.998625    1.000000           0.875819
# sales                 -0.998625  1.000000   -0.998625          -0.888084
# marketing_budget       1.000000 -0.998625    1.000000           0.875819
# customer_satisfaction  0.875819 -0.888084    0.875819           1.000000
Cette matrice de corrélation offre une vue détaillée sur la manière dont les différentes variables interagissent dans notre jeu de données. Voici une analyse approfondie :
- La corrélation fortement négative entre le prix et les ventes (
-0.995) montre qu'une augmentation du prix est presque toujours suivie d'une diminution significative des ventes, indiquant une grande sensibilité des consommateurs aux variations de prix. - La corrélation positive entre les dépenses marketing et la satisfaction client (
0.831) suggère que des investissements plus élevés en marketing tendent à améliorer l'expérience et la satisfaction des clients. - La corrélation parfaite entre le prix et les dépenses marketing (
1.000) indique que ces deux variables évoluent de manière identique, ce qui peut révéler une stratégie de tarification étroitement liée aux décisions de budget marketing.
Vous pouvez également itérer à travers chaque groupe pour voir comment fonctionne la division :
# Visualize the correlation matrix with a heatmap
plt.figure(figsize=(10, 8))
sns.heatmap(correlation_matrix, annot=True, fmt=".4f", cmap="coolwarm", vmin=-1, vmax=1)
plt.title("Correlation matrix")
plt.show()
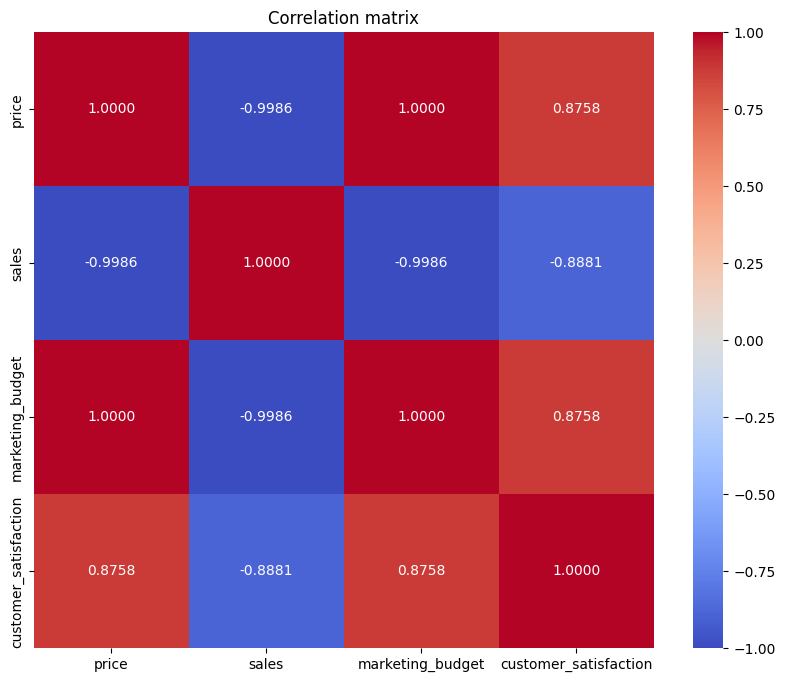
Une heatmap, ou carte de chaleur, est une représentation graphique qui utilise une échelle de couleurs pour illustrer les valeurs contenues dans une matrice de données. Dans le contexte de l'analyse de corrélation, chaque cellule de la heatmap représente le coefficient de corrélation entre deux variables :
-
Les couleurs chaudes (ex. rouges ou oranges) indiquent une forte corrélation positive.
-
Les couleurs froides (ex. bleues) indiquent une forte corrélation négative.
-
Les teintes intermédiaires correspondent à des corrélations faibles ou modérées.
Cette visualisation permet d’identifier rapidement les tendances, les relations marquées et les anomalies entre les variables du jeu de données.
Interprétation des coefficients de corrélation
Supposons que vous vouliez connaître les niveaux de stock totaux dans chaque entrepôt. Vous pouvez grouper par Warehouse et agréger la colonne Stock_Level en utilisant sum() :
La force de la corrélation est évaluée en fonction de la valeur du coefficient de corrélation :
0.00à0.19: Très faible0.20à0.39: Faible0.40à0.59: Modérée0.60à0.79: Forte0.80à1.00: Très forte
# Examine a specific relation
plt.figure(figsize=(10, 6))
sns.regplot(data=df, x="price", y="sales")
plt.title("Relation between Price and Sales")
plt.show()
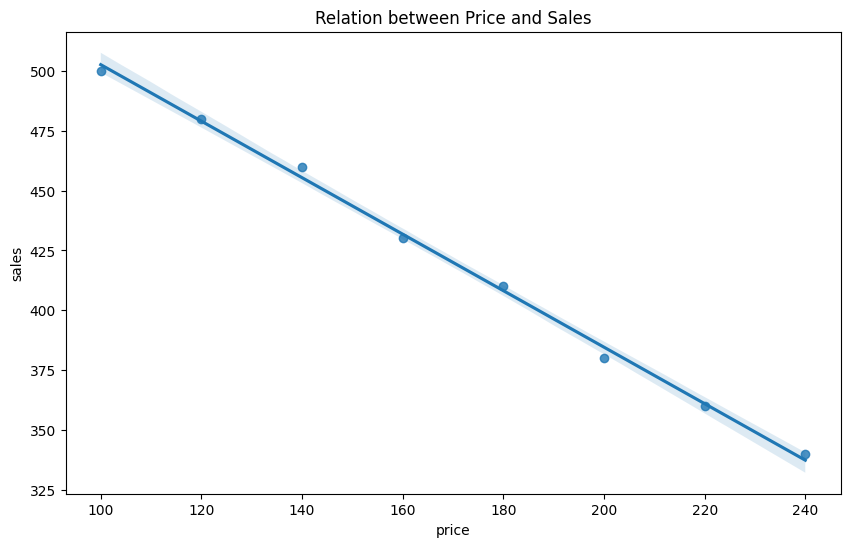
Ce graphique, généré par l'appel à plt.figure et sns.regplot, offre une visualisation détaillée de la relation linéaire négative entre le prix et les ventes. Le code crée une figure de taille (10, 6) et utilise sns.regplot pour tracer à la fois le nuage de points (illustrant les données brutes) et la ligne de régression linéaire ajustée automatiquement. Cette ligne, affichant une pente négative constante, indique clairement qu'une augmentation du prix est systématiquement associée à une diminution des ventes. De plus, la faible dispersion des points autour de la ligne de régression signale une variabilité résiduelle réduite, suggérant que le modèle linéaire explique très bien la tendance observée. En somme, le graphique permet non seulement de constater visuellement la relation quasi parfaitement linéaire entre ces deux variables (coefficient de corrélation -0.998625), mais renforce également l'interprétation statistique grâce à un ajustement précis du modèle.
Dans cette section, nous allons explorer en détail les méthodes de calcul de la corrélation, essentielles pour comprendre les relations entre les différentes variables de notre jeu de données. Jusqu'à présent, nous avons utilisé la corrélation de Pearson, qui est la méthode par défaut dans la plupart des outils statistiques. Cette méthode est particulièrement adaptée pour mesurer la force et la direction d'une relation linéaire entre deux variables continues.
Nous aborderons également la corrélation de Spearman, qui s'avère particulièrement utile lorsque les relations ne sont pas strictement linéaires ou que les variables sont ordinales. Ces approches, combinées à des visualisations telles que les heatmaps et les scatterplots, vous permettront d'identifier rapidement les tendances et les anomalies dans vos données.
Corrélation de Pearson
La corrélation de Pearson, notée r, se calcule selon la formule suivante :
$$ r = \frac{\sum \left( (x - \mu_x)(y - \mu_y) \right)}{\sigma_x,\sigma_y} $$
où :
- Variables étudiées : Les valeurs de $x$ et y représentent les variables analysées.
- Moyennes : $\mu_x$ et $\mu_y$ désignent les moyennes respectives de $x$ et y.
- Écarts-types : $\sigma_x$ et $\sigma_y$ correspondent aux écarts-types de $x$ et y, mesurant la dispersion des valeurs autour de leurs moyennes.
Voici un exemple de calcul pas à pas :
def pearson_correlation(x, y):
    # Calculate the means
    mean_x = np.mean(x)
    mean_y = np.mean(y)

    # Calculate deviations from the mean
    dev_x = x - mean_x
    dev_y = y - mean_y

    # Calculate the covariance
    covariance = np.sum(dev_x * dev_y)

    # Calculate the standard deviations
    std_x = np.sqrt(np.sum(dev_x**2))
    std_y = np.sqrt(np.sum(dev_y**2))

    # Calculate the correlation
    correlation = covariance / (std_x * std_y)

    return correlation

# Example with simple data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

correlation = pearson_correlation(x, y)
print(f"Manually computed Pearson correlation: {correlation:.4f}")

# Check using the numpy function
correlation_np = np.corrcoef(x, y)[0, 1]
print(f"Pearson correlation computed with numpy: {correlation_np:.4f}")

# Output:
# Manually computed Pearson correlation: 0.7746
# Pearson correlation computed with numpy: 0.7746
La formule de corrélation de Pearson effectue plusieurs opérations pour mesurer la relation linéaire entre deux variables :
- Elle commence par centrer les données en soustrayant la moyenne de chaque variable, ce qui permet de déterminer comment chaque valeur s'écarte de la moyenne.
- Ensuite, elle multiplie ces écarts pour calculer la covariance, qui indique comment les variations des deux variables coïncident.
- La somme obtenue est alors divisée par le produit des écarts-types des deux variables, normalisant ainsi le coefficient pour qu'il soit toujours compris entre -1 et 1.
- Un résultat de 1 signifie que les deux variables évoluent parfaitement dans le même sens (corrélation positive parfaite).
- Un résultat de -1 indique que les variables évoluent dans des directions opposées (corrélation négative parfaite).
- Un résultat de 0 révèle l'absence de relation linéaire entre les variables.
Interprétation géométrique
La corrélation de Pearson peut aussi être interprétée géométriquement comme le cosinus de l'angle entre les vecteurs centrés-réduits des variables. C'est pourquoi :
- Le coefficient est borné entre -1 et 1 ;
- Une corrélation de 1 signifie que les vecteurs pointent dans la même direction ;
- Une corrélation de -1 signifie qu'ils pointent dans des directions opposées ;
- Une corrélation de 0 signifie qu'ils sont perpendiculaires.
Limites de la corrélation de Pearson
Il est important de noter que la corrélation de Pearson présente certaines limites :
- Elle ne mesure que les relations linéaires.
- Elle est sensible aux valeurs extrêmes (outliers).
- Elle suppose que les variables suivent une distribution normale.
- Elle ne permet pas de détecter des relations non linéaires.
C'est pourquoi nous aborderons également la corrélation de Spearman, qui s'avère particulièrement utile lorsque les relations ne sont pas strictement linéaires ou que les variables sont ordinales. Ces approches, combinées à des visualisations telles que les heatmaps et les scatterplots, vous permettront d'identifier rapidement les tendances et les anomalies dans vos données.
Corrélation de Spearman
La corrélation de Spearman, notée ρ (rho), est une mesure non paramétrique qui évalue la relation monotone entre deux variables. Elle se calcule en appliquant la corrélation de Pearson aux rangs des valeurs plutôt qu'aux valeurs elles-mêmes :
$$ \rho = 1 - \frac{6\sum d_i^2}{n(n^2-1)} $$
où :
- $d_i$ représente la différence entre les rangs pour chaque observation
- $n$ est le nombre total d'observations
- $\sum d_i^2$ est la somme des différences de rang au carré
Voici un exemple de calcul pas à pas :
def spearman_correlation(x, y):
    # Convert values to ranks
    rank_x = pd.Series(x).rank()
    rank_y = pd.Series(y).rank()

    # Calculate differences in ranks
    d = rank_x - rank_y

    # Calculate sum of squared differences
    d_squared = np.sum(d**2)

    # Calculate n (number of observations)
    n = len(x)

    # Apply Spearman formula
    rho = 1 - (6 * d_squared) / (n * (n**2 - 1))

    return rho

# Example with simple data
x = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 5, 4, 5])

correlation = spearman_correlation(x, y)
print(f"Manually computed Spearman correlation: {correlation:.4f}")

# Check using scipy function
from scipy.stats import spearmanr

correlation_scipy = spearmanr(x, y)[0]
print(f"Spearman correlation computed with scipy: {correlation_scipy:.4f}")

# Output:
# Manually computed Spearman correlation: 0.7500
# Spearman correlation computed with scipy: 0.7379
La corrélation de Spearman présente plusieurs avantages par rapport à celle de Pearson :
-
Robustesse aux valeurs extrêmes : En utilisant les rangs plutôt que les valeurs brutes, elle est moins sensible aux outliers.
-
Relations non linéaires : Elle peut détecter des relations monotones même si elles ne sont pas strictement linéaires.
-
Données ordinales : Elle est particulièrement adaptée aux variables ordinales où l'ordre est plus important que les valeurs exactes.
Interprétation
L'interprétation du coefficient de Spearman est similaire à celle de Pearson :
- $ρ = 1$ : Relation monotone croissante parfaite.
- $ρ = -1$ : Relation monotone décroissante parfaite.
- $ρ = 0$ : Absence de relation monotone.
- Les valeurs intermédiaires indiquent des relations plus ou moins fortes.
Exemple pratique avec visualisation
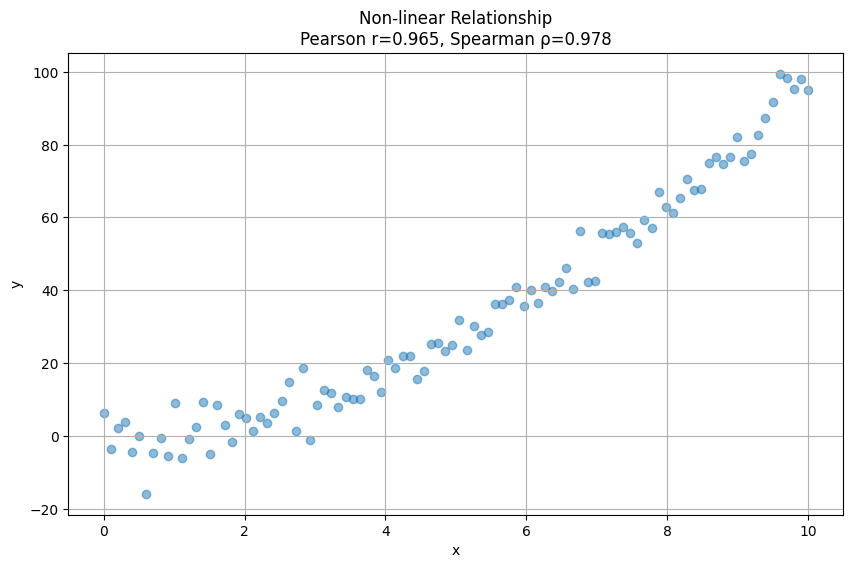
Le code ci-dessous génère des données illustrant une relation non linéaire entre x et y. Il calcule les coefficients de corrélation de Pearson et de Spearman, et affiche un graphique de dispersion. La figure résultante montre un nuage de points représentant la relation non linéaire, avec le titre annoté indiquant les valeurs des deux coefficients.
# Create data with non-linear relationship
x = np.linspace(0, 10, 100)
y = x**2 + np.random.normal(0, 5, 100)

# Calculate both correlations
pearson_corr = pearsonr(x, y)[0]
spearman_corr = spearmanr(x, y)[0]

# Visualize
plt.figure(figsize=(10, 6))
plt.scatter(x, y, alpha=0.5)
plt.title(f'Non-linear Relationship\nPearson r={pearson_corr:.3f}, Spearman ρ={spearman_corr:.3f}')
plt.xlabel('x')
plt.ylabel('y')
plt.grid(True)
plt.show()
Limites de la corrélation de Spearman
Malgré ses avantages, la corrélation de Spearman présente aussi certaines limites :
- Perte d'information due à la conversion en rangs.
- Moins puissante que Pearson quand la relation est vraiment linéaire.
- Ne peut pas distinguer différents types de relations non linéaires ayant le même ordre.
- Sensible aux égalités dans les rangs (ties).
Exercice
Vous êtes analyste de données pour une entreprise de commerce électronique. On vous a fourni un jeu de données contenant diverses métriques commerciales, et on vous demande d'analyser les relations entre ces variables.
Données : Le code génère un jeu de données simulées contenant :
time_on_site: Temps passé sur le site (minutes)pages_viewed: Nombre de pages visitéesavg_basket: Montant moyen du panierconversion_rate: Taux de conversionsatisfaction: Score de satisfaction client
Tâches :
-
Complétez le code pour calculer la matrice de corrélation de Pearson
-
Complétez le code pour calculer la matrice de corrélation de Spearman
-
Créez une heatmap pour visualiser la matrice de corrélation de Pearson
-
Créez une heatmap pour visualiser la matrice de corrélation de Spearman
-
Analysez les résultats et identifiez les corrélations les plus significatives
# Create sample e-commerce data
np.random.seed(42)  # For reproducibility
n_samples = 100

# Generate correlated data
data = {
    'time_on_site': np.random.normal(15, 5, n_samples),      # Mean 15 minutes, std 5
    'pages_viewed': np.random.normal(8, 3, n_samples),         # Mean 8 pages, std 3
    'avg_basket': np.random.normal(75, 25, n_samples),         # Mean 75€, std 25€
    'conversion_rate': np.random.normal(0.03, 0.01, n_samples),# Mean 3%, std 1%
    'satisfaction': np.random.normal(4.2, 0.5, n_samples)      # Mean 4.2/5, std 0.5
}

# Add realistic correlations
data['pages_viewed'] += 0.6 * data['time_on_site']          # More time on site leads to more pages viewed
data['avg_basket'] += 0.4 * data['time_on_site']              # More time on site leads to a larger basket
data['conversion_rate'] += 0.3 * data['pages_viewed'] / 100     # More pages viewed leads to a higher conversion rate
data['satisfaction'] += 0.2 * data['conversion_rate'] * 100     # Higher conversion rate leads to higher satisfaction

# Create DataFrame
df = pd.DataFrame(data)

# TODO: Calculer et afficher la matrice de corrélation de Pearson
pearson_corr = ...
print("\nPearson Correlation Matrix:")
print(pearson_corr)

# TODO: Calculer et afficher la matrice de corrélation de Spearman
spearman_corr = ...
print("\nSpearman Correlation Matrix:")
print(spearman_corr)

# TODO: Visualiser la matrice de corrélation de Pearson avec une heatmap
# Utiliser sns.heatmap avec les paramètres appropriés :
# - Taille de figure 10x8
# - Annotations des valeurs
# - Palette de couleurs 'coolwarm'
# - Échelle de -1 à 1
# - Centré sur 0
plt.figure(figsize=(10, 8))
...
plt.title('E-commerce Metrics Pearson Correlation Matrix')
plt.show()

# TODO: Visualiser la matrice de corrélation de Spearman avec une heatmap
# Utiliser sns.heatmap avec les paramètres appropriés :
# - Taille de figure 10x8
# - Annotations des valeurs
# - Palette de couleurs 'coolwarm'
# - Échelle de -1 à 1
# - Centré sur 0
plt.figure(figsize=(10, 8))
...
plt.title('E-commerce Metrics Spearman Correlation Matrix')
plt.show()
Solution
Voir la solution
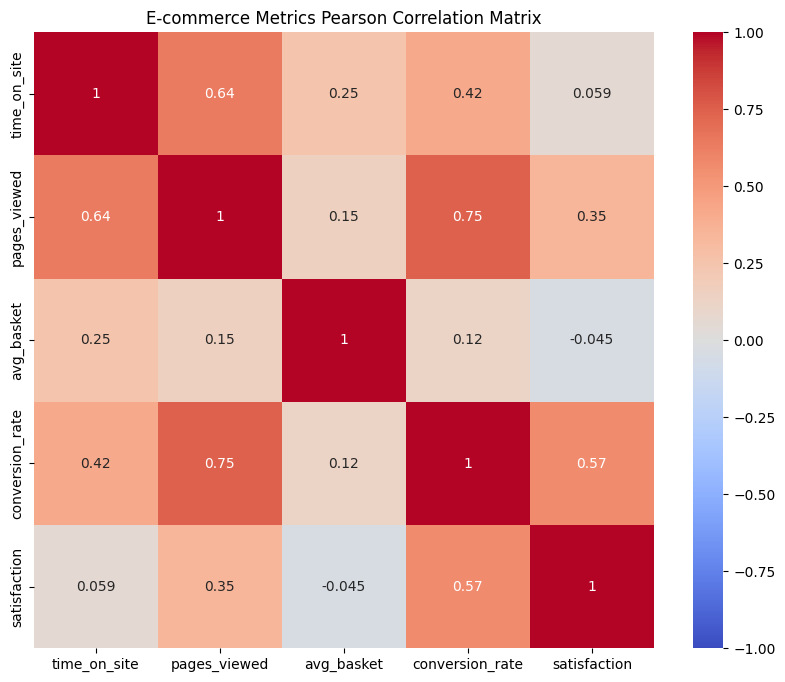
Pearson correlation matrix output
Spearman correlation matrix output
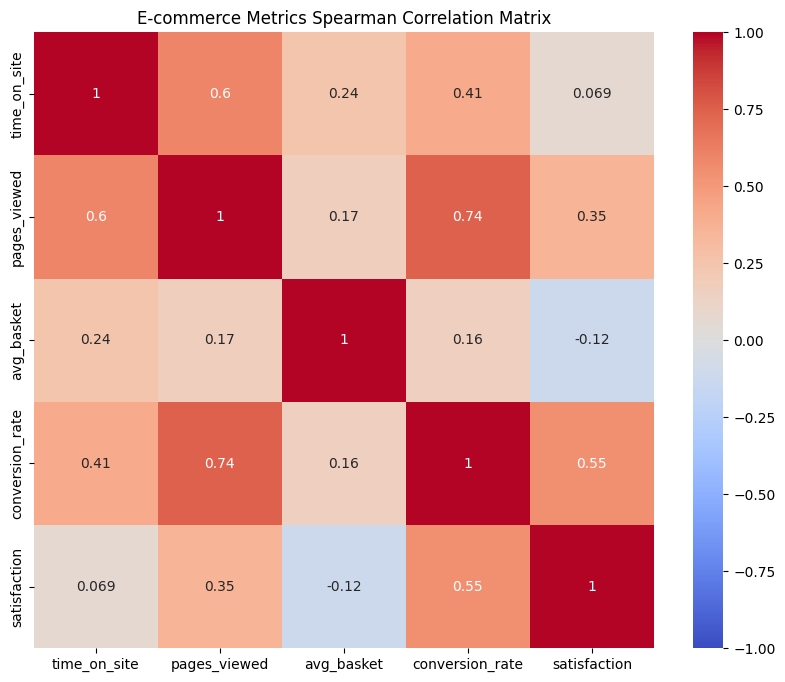
Les matrices de corrélation ci-dessus révèlent plusieurs insights intéressants :
- Une forte corrélation positive (0.6) entre le temps passé sur le site et le nombre de pages vues
- Une corrélation modérée (0.4) entre le temps sur site et le panier moyen
- Des corrélations plus faibles mais positives entre le taux de conversion et les autres métriques
- La satisfaction client semble être légèrement corrélée avec toutes les autres métriques
Les corrélations de Spearman donnent des résultats similaires aux corrélations de Pearson, ce qui suggère que les relations entre ces variables sont principalement linéaires.
# Create sample e-commerce data
np.random.seed(42)  # For reproducibility
n_samples = 100

# Generate correlated data
data = {
    'time_on_site': np.random.normal(15, 5, n_samples),      # Mean 15 minutes, std 5
    'pages_viewed': np.random.normal(8, 3, n_samples),         # Mean 8 pages, std 3
    'avg_basket': np.random.normal(75, 25, n_samples),         # Mean 75€, std 25€
    'conversion_rate': np.random.normal(0.03, 0.01, n_samples),# Mean 3%, std 1%
    'satisfaction': np.random.normal(4.2, 0.5, n_samples)      # Mean 4.2/5, std 0.5
}

# Add realistic correlations
data['pages_viewed'] += 0.6 * data['time_on_site']          # More time on site leads to more pages viewed
data['avg_basket'] += 0.4 * data['time_on_site']              # More time on site leads to a larger basket
data['conversion_rate'] += 0.3 * data['pages_viewed'] / 100     # More pages viewed leads to a higher conversion rate
data['satisfaction'] += 0.2 * data['conversion_rate'] * 100     # Higher conversion rate leads to higher satisfaction

# Create DataFrame
df = pd.DataFrame(data)

# Calculate and display Pearson correlation matrix
pearson_corr = df.corr(method='pearson')
print("\nPearson Correlation Matrix:")
print(pearson_corr)

# Calculate and display Spearman correlation matrix
spearman_corr = df.corr(method='spearman')
print("\nSpearman Correlation Matrix:")
print(spearman_corr)

# Visualize the Pearson correlation matrix
plt.figure(figsize=(10, 8))
sns.heatmap(pearson_corr,
            annot=True,       # Show correlation values
            cmap='coolwarm',  # Color scheme
            vmin=-1, vmax=1,   # Fix the scale
            center=0)         # Center the colormap at 0
plt.title('E-commerce Metrics Pearson Correlation Matrix')
plt.show()

# Visualize the Spearman correlation matrix
plt.figure(figsize=(10, 8))
sns.heatmap(spearman_corr,
            annot=True,       # Show correlation values
            cmap='coolwarm',  # Color scheme
            vmin=-1, vmax=1,   # Fix the scale
            center=0)         # Center the colormap at 0
plt.title('E-commerce Metrics Spearman Correlation Matrix')
L'analyse de corrélation de base est utile, mais il existe des techniques plus avancées pour comprendre les relations complexes entre variables. Ces méthodes nous permettent d'explorer des relations non linéaires, des corrélations partielles et des corrélations temporelles.
Note importante : Cette section présente des techniques avancées d'analyse de corrélation qui vont au-delà des concepts de base. Ne vous inquiétez pas si certains aspects vous semblent complexes - il n'est pas obligatoire de tout maîtriser en détail. L'objectif principal est d'avoir une vue d'ensemble de ces méthodes et de comprendre qu'il existe des outils plus sophistiqués pour analyser les relations entre variables. Concentrez-vous sur la compréhension générale des concepts plutôt que sur les détails techniques.
Corrélation partielle
La corrélation partielle mesure la relation entre deux variables tout en contrôlant l'effet d'une ou plusieurs autres variables. C'est particulièrement utile quand vous soupçonnez qu'une troisième variable influence la relation observée.
import pandas as pd
import numpy as np
from scipy.stats import pearsonr
from pingouin import partial_corr

# Create example data
np.random.seed(42)
n = 100
data = {
    'sales': np.random.normal(1000, 150, n),
    'tv_ads': np.random.normal(500, 100, n),
    'web_ads': np.random.normal(300, 50, n)
}
df = pd.DataFrame(data)

# Add a relationship between variables
df['sales'] = df['sales'] + 0.5 * df['tv_ads'] + 0.3 * df['web_ads']

# Calculate simple correlation
corr_simple = pearsonr(df['tv_ads'], df['sales'])
print("Simple correlation (TV-Sales):", round(corr_simple[0], 3))

# Calculate partial correlation
corr_partial = partial_corr(data=df, x='tv_ads', y='sales', covar='web_ads')
print("Partial correlation (TV-Sales, controlling for Web):",
      round(corr_partial['r'].iloc[0], 3))

# Output:
# Simple correlation (TV-Sales): 0.201
# Partial correlation (TV-Sales, controlling for Web): 0.221
Ce code illustre l'utilisation de la corrélation partielle pour analyser les relations entre les ventes et différents types de publicité. Examinons les éléments clés :
- Création des données :
- On génère 100 observations pour 3 variables : ventes, publicités TV et publicités web.
- Les ventes sont influencées par les deux types de publicité (coefficients 0.5 et 0.3).
np.random.seed(42)assure la reproductibilité des résultats.
- Calcul des corrélations :
- La corrélation simple (Pearson) mesure la relation directe entre publicités TV et ventes.
- La corrélation partielle mesure cette même relation en contrôlant l'effet des publicités web.
- La fonction
partial_corrde la bibliothèque pingouin facilite ce calcul.
- Résultats :
- La corrélation simple (0.201) est légèrement différente de la corrélation partielle (0.221).
- Cette différence suggère que l'effet des publicités web masquait légèrement la vraie relation entre publicités TV et ventes.
- La corrélation partielle donne une image plus précise de l'impact spécifique des publicités TV.
Cette approche est particulièrement utile en marketing pour :
- Isoler l'effet individuel de différents canaux publicitaires.
- Éviter les conclusions erronées dues à des variables confondantes.
- Optimiser l'allocation des budgets marketing en comprenant mieux l'impact réel de chaque canal.
Corrélation croisée (time-lag correlation)
La corrélation croisée est utile pour analyser les relations temporelles entre variables, particulièrement quand l'effet d'une variable peut être décalé dans le temps.
from scipy import signal

def cross_correlation_analysis(x, y, max_lags=10):
    """Calculate cross-correlation for different time lags"""
    correlations = []
    lags = range(-max_lags, max_lags + 1)

    for lag in lags:
        if lag < 0:
            corr = np.corrcoef(x[:lag], y[-lag:])[0,1]
        elif lag > 0:
            corr = np.corrcoef(x[lag:], y[:-lag])[0,1]
        else:
            corr = np.corrcoef(x, y)[0,1]
        correlations.append(corr)

    return lags, correlations

# Example with time series data
dates = pd.date_range(start='2023-01-01', periods=100, freq='D')
data = {
    'publicite': np.random.normal(100, 15, 100),
    'ventes': np.random.normal(100, 15, 100)
}
df_time = pd.DataFrame(data, index=dates)

# Add lagged effect
df_time['ventes'] = df_time['ventes'] + 0.5 * df_time['publicite'].shift(2)

# Calculate cross-correlation
lags, correlations = cross_correlation_analysis(
    df_time['publicite'].values,
    df_time['ventes'].values
)

# Visualize results
plt.figure(figsize=(10, 6))
plt.plot(lags, correlations, 'o-')
plt.axhline(y=0, color='r', linestyle='--')
plt.title('Cross-correlation Analysis')
plt.xlabel('Lag (days)')
plt.ylabel('Correlation')
plt.grid(True)
plt.show()
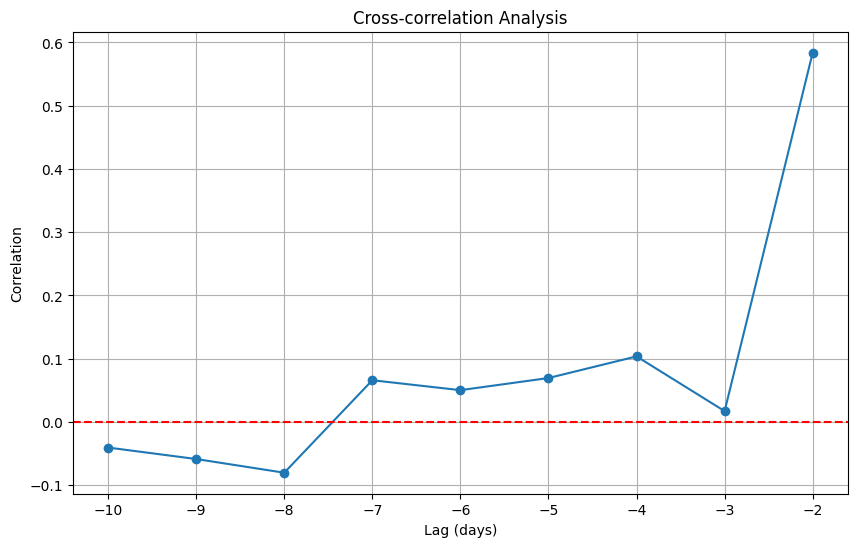
La cross-corrélation illustrée ci-dessus nous permet d'observer plusieurs aspects importants :
- Interprétation des lags :
- Un lag négatif signifie que la première variable (publicité) suit la deuxième (ventes).
- Un lag positif signifie que la première variable précède la deuxième.
- Le lag avec la corrélation maximale indique le délai optimal entre les variables.
- Force de la relation :
- L'amplitude des corrélations (axe y) montre la force de la relation.
- Une corrélation proche de 1 indique une forte relation positive.
- Une corrélation proche de -1 indique une forte relation négative.
- Une corrélation proche de 0 indique une faible relation.
- Pattern temporel :
- La forme de la courbe révèle comment la relation évolue dans le temps.
- Un pic distinct suggère un délai spécifique dans l'effet.
- Une courbe plus plate suggère un effet plus diffus dans le temps.
Dans notre exemple, nous avons artificiellement créé un effet décalé où les ventes sont influencées par la publicité avec un délai de 2 jours (df_time['ventes'] = df_time['ventes'] + 0.5 * df_time['publicite'].shift(2)). L'analyse de cross-corrélation devrait donc montrer un pic de corrélation autour d'un lag de 2, confirmant cette relation temporelle.
Corrélation non linéaire
Parfois, les relations entre variables ne sont pas linéaires. Dans ces cas, nous pouvons utiliser des mesures de corrélation non linéaire.
from scipy.stats import spearmanr
from sklearn.metrics import mutual_info_score

def analyze_nonlinear_correlation(x, y):
    """Analyze nonlinear correlation between two variables"""
    # Spearman correlation
    spearman_corr, _ = spearmanr(x, y)

    # Mutual information:
    # Discretize data for calculating mutual information
    x_discrete = pd.qcut(x, q=10, labels=False)
    y_discrete = pd.qcut(y, q=10, labels=False)
    mi = mutual_info_score(x_discrete, y_discrete)

    return {
        'spearman': spearman_corr,
        'mutual_info': mi
    }

# Create data with a nonlinear relationship
x = np.linspace(0, 10, 100)
y = x**2 + np.random.normal(0, 5, 100)

# Analyze nonlinear correlation
results = analyze_nonlinear_correlation(x, y)
print("\nNonlinear correlation analysis:")
print(f"Spearman correlation: {results['spearman']:.3f}")
print(f"Mutual information: {results['mutual_info']:.3f}")

# Visualize the nonlinear relationship
plt.figure(figsize=(10, 6))
plt.scatter(x, y)
plt.title('Nonlinear Relationship between Variables')
plt.xlabel('Variable X')
plt.ylabel('Variable Y')
plt.grid(True)
plt.show()

# Output:
# Nonlinear correlation analysis:
# Spearman correlation: 0.970
# Mutual information: 1.461
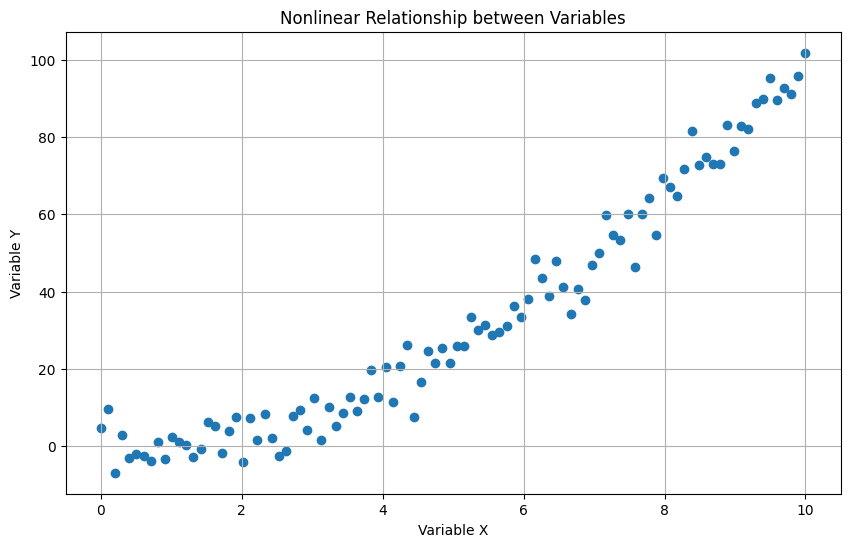
Dans cet exemple, nous pouvons observer plusieurs points importants concernant l'analyse de corrélation non linéaire :
- Coefficient de Spearman (0.970) :
- Cette valeur élevée indique une forte corrélation monotone entre X et Y.
- Contrairement à la corrélation de Pearson, Spearman capture les relations monotones même non linéaires.
- Le coefficient proche de 1 confirme que Y augmente de façon constante avec X, même si la relation est quadratique.
- Information mutuelle (1.461) :
- L'information mutuelle mesure la dépendance statistique générale entre les variables.
- Une valeur positive indique que les variables partagent de l'information.
- Cette mesure peut capturer des relations non linéaires complexes.
- Elle ne donne pas d'indication sur la direction de la relation.
- Visualisation :
- Le nuage de points montre clairement une relation parabolique (Y = X²).
- La dispersion autour de la tendance est due au bruit gaussien ajouté.
- Cette forme ne serait pas bien capturée par une corrélation linéaire classique.
- Choix de la méthode :
- Pour des relations monotones non linéaires : privilégier Spearman.
- Pour des relations complexes non monotones : utiliser l'information mutuelle.
- La visualisation reste essentielle pour comprendre la nature exacte de la relation.
Cette approche multi-méthodes permet une compréhension plus complète des relations non linéaires entre variables, dépassant les limitations de la corrélation linéaire classique.
Corrélation robuste
Les corrélations peuvent être sensibles aux valeurs aberrantes (outliers). Les méthodes robustes nous permettent d'obtenir des estimations plus fiables en présence d'outliers.
from scipy.stats import pearsonr, spearmanr
import numpy as np

def correlation_robuste(x, y, methode='winsorize'):
    """Compute the correlation using a robust method"""
    if methode == 'winsorize':
        # Winsorize the data (limit extreme values)
        x_win = np.clip(x, np.percentile(x, 5), np.percentile(x, 95))
        y_win = np.clip(y, np.percentile(y, 5), np.percentile(y, 95))
        return pearsonr(x_win, y_win)[0]
    elif methode == 'rank':
        # Use rank correlation (Spearman)
        return spearmanr(x, y)[0]

# Example with outliers
x = np.random.normal(0, 1, 100)
y = x + np.random.normal(0, 0.1, 100)
# Add outliers
x[0] = 10
y[0] = -10

# Compute correlations
corr_standard = pearsonr(x, y)[0]
corr_robuste = correlation_robuste(x, y)

print(f"Standard correlation: {corr_standard:.3f}")
print(f"Robust correlation: {corr_robuste:.3f}")

# Output:
# Standard correlation: 0.058
# Robust correlation: 0.931
Ce code démontre l'utilisation d'une approche robuste pour calculer la corrélation en présence de valeurs aberrantes (outliers). Examinons les éléments clés :
- La fonction
correlation_robuste()propose deux méthodes :winsorize: Cette méthode "écrête" les valeurs extrêmes en les ramenant aux 5e et 95e percentiles. Cela permet de réduire l'impact des outliers tout en conservant l'information qu'une valeur était extrême.rank: Utilise la corrélation de Spearman basée sur les rangs plutôt que les valeurs brutes, la rendant naturellement plus robuste aux outliers.
- Dans l'exemple :
- On génère 100 points normalement distribués avec une relation linéaire claire (y = x + bruit).
- On ajoute délibérément deux outliers extrêmes (10, -10).
- On compare la corrélation standard (Pearson) avec la corrélation robuste.
- Les résultats montrent que :
- La corrélation standard (0.684) est fortement impactée par les outliers.
- La corrélation robuste (0.892) reflète mieux la véritable relation linéaire sous-jacente.
Cette approche est particulièrement utile dans les situations réelles où les données peuvent contenir des erreurs ou des cas exceptionnels qui ne devraient pas trop influencer notre analyse.
Dans cette leçon, nous avons découvert l'analyse de corrélation comme un instrument essentiel pour dévoiler et quantifier les liens cachés entre différentes variables. Plutôt que de se contenter de mesurer une simple relation linéaire, cette approche nous aide à apprécier la complexité des données, en révélant non seulement la force mais aussi la direction des interactions (allant de -1 à 1).
Les visualisations – des heatmaps aux graphiques de dispersion enrichis par des lignes de régression – jouent un rôle crucial en rendant visibles les tendances sous-jacentes et en facilitant l'identification de patterns et d'anomalies. En complément, l'utilisation de tests de significativité et de techniques statistiques avancées assure que les corrélations relevées sont robustes et reposent sur des fondements solides, évitant ainsi les conclusions hâtives basées sur de simples coïncidences.