3. Les caractères
Après cette quête, tu sauras comment manipuler des caractères
Objectifs
- Connaître la représentation des caractères en mémoire
- Comprendre la notion d'encodage de caractères
- Connaître ASCII
- Connaître Unicode
Pardon ? Qu'avez-vous dit ?
Tu débarques dans un pays inconnu. Tu ne connais ni l'alphabet, ni la langue. Pourtant la langue qu'ils parlent ressemble fortement à la tienne, mais tu ne parviens pas à en saisir les spécificités.
Mais heureusement, je suis là pour t'apprendre à communiquer dans tous les langages de manière fluide sans heurts ni pleurs, ni insultes non voulues.
Allez, en avant !
Représentation des caractères
C'est quoi un caractère ?
Un caractère représente une lettre, un signe de ponctuation, une tabulation, un saut de ligne, les signes mathématiques ... En gros, tout le texte affiché à l'écran est constitué de caractères. Il y a certains caractères spéciaux qui font des choses particulières (retour en début de ligne, faire retentir une sonnerie dans un terminal, fermer un flux ...).
Toute valeur sur un circuit d'ordinateur est représenté par une chaîne binaire. Les caractères n'échappent pas à la règle. Les caractères ne sont pour l'impitoyable circuiterie de l'ordinateur que des 0 et des 1 chaînés les uns aux autres. Il n'y a qu'un nombre fini de caractères qui peuvent être représentés.
Mais il y a beaucoup de caractères, comment on fait pour tous les représenter ?
Les encodages
La gestion des caractères n'est pas chose facile, et évolue encore et encore au fil du temps pour représenter de plus en plus de symboles. Il y a des symboles appartenant à une langue et n'appartenant pas une autre, il y a des lettres qui peuvent être accentuées dans certaines langues et pas dans d'autres. Certaines langues utilisent un alphabet totalement différent des autres (alphabet cyrillique, kanji ...). La gestion des caractères est un domaine d'experts.
Lesdits experts écrivent des conventions de représentation machine des caractères, ils doivent choisir le bon nombre d'octets encodant un ensemble de lettres pour n'être lésés sur aucune des langues existantes, tout en réduisant au maximum la mémoire occupée par les caractères.
Pour atteindre le but ultime qui est de pouvoir représenter tous les caractères présents sur Terre, les experts ont mis au point des encodages de caractères. Ce sont des normes de représentation en mémoire des caractères. Il en existe beaucoup, vraiment beaucoup. En France, nous utilisons majoritairement la norme latin-9 et ses variantes (arrivez-vous à mettre un accent sur une lettre majuscule ?).
Et alors, quels encodages existent ?
Lire "qu'est-ce que l'encodage de caractères"
ASCII
Il y a un encodage à connaître qui permet de communiquer à l'international : la norme ASCII. Cet encodage est pratique à représenter car il ne comprend aucun accent. L'encodage ASCII utilise un et un seul octet pour coder les caractères. Un octet dispose de 255 valeurs possibles.
Cet encodage ne peut représenter que 255 caractères. Actuellement ASCII standard ne représente que 127 caractères. L'autre moitié est réservée pour ajouts et améliorations.
L'encodage ASCII standard ne prend pas en compte les accents. Cet encodage intègre les lettres de l'alphabet majuscules et minuscules, les chiffres, les signes de ponctuation internationaux (oubliez le point d'interrogation inversé de la langue espagnole), certains symboles mathématiques, l'arobase, ainsi que d'autres codes réalisant des actions spéciales (BEL pour faire sonner le terminal, EOT pour signifier la fin d'un texte ...).
255 caractères, ça fait peu ... T'as pas mieux ?
Unicode et UTF-8
Quand l'Internet est apparu au grand public (les utilisateurs de ce merveilleux outil parlant d'autres langues, ayant des symboles différents), il existait énormément d'extensions différentes d'ASCII. Cette technique marchait bien pour les personnes parlant la même langue, mais à l'international, c'était l'enfer. 255 caractères pour le monde entier n'est assurément pas suffisant.
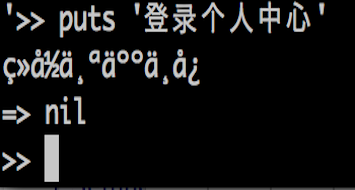
Tu as déjà dû apercevoir, alors que tu naviguais sur des sites web, des caractères bizarres ressemblant vaguement à “©”. Voire carrément des ALT+321 à la place des symboles internationaux. Il est même possible que tu aies navigué sur un site au contenu textuel entièrement illisible. Tu peux penser que les codeurs qui ont implémenté ces sites n'avaient pas de notion d'encodage et se sont lancés dans l'écriture d'un site ou d'une application client sans prendre en considération les conventions sur la restitution de contenu textuel à l'international.
Alors, des types intelligents ont créé un consortium: l'Unicode Consortium. Unicode pour Universal Coded Character Set. La subtilité avec Unicode est que ce n'est pas à proprement parler un encodage, mais une manière de les interpréter. Voici comment on écrit "Hello" en unicode:
U+0048 U+0065 U+006C U+006C U+006F
Unicode représente un seul caractère sur plusieurs octets, ce qui permet une infinité de caractères différents. Ce qui est un peu mieux qu'ASCII qui n'en offre que 255 maximum.
Chaque élément du mot est un point de code. Il s'agit d'une différence par rapport au début d'un charset (ensemble de caractères). Les symboles Unicode sont contenus dans des charsets. Le charset le plus utilisé en occident est aujourd'hui l'UTF-8. D'ailleurs, si tu es curieux, tu peux jeter un oeil à l'en-tête HTTP Content-Type qui contient le charset avec lequel ton navigateur va lire les points de code Unicode. Les sites bien codés envoient un en-tête qui spécifie le charset utilisé.
Le type ‘char’
Le type représentant un caractère en C# est char. Un charen C# est codé sur deux octets pour représenter Unicode, alors que dans d'autres langages, il est souvent codé sur un seul octet, ce qui permet uniquement d'utiliser la table ASCII pour représenter des caractères.
Un caractère en C# est entouré d'apostrophes ('). Il ne peut pas être entouré d'autres caractères. Si tu l'entoures avec des guillemets, il n'aura pas le type char, mais string (que l'on verra un peu plus tard).
char est convertible en d'autres types, comme int ou byte. Pour convertir un type dans un autre (sans altérer sa représentation en mémoire), on utilise ce que l’on appelle un cast. Un cast est l’opération consistant à prendre une représentation et la changer dans un autre type. On réalise un cast en faisant précéder une variable du type entre parenthèses.
Exemple:
char h = 'u0048'; // H
char e = 'u0065'; // e
char l = 'l'; // l
char o = (char)0x6F;// o - cast d’un entier hexadécimal vers un char
Ressources
Challenge
Alphabet
Ecris un programme qui instancie toutes les lettres de l'alphabet en minuscules, à partir de valeurs en nombres entiers de l'encodage ASCII:
- a = 'a'
- ...
- z = 'z'
Critères de validation
- Un lien vers ta solution sur GitHub
- Les caractères sont affectés à partir de valeurs entières