0. Intro - Un programme exécutable
Après cette quête, tu auras intégré les bases de la théorie des programmes
Objectifs
- Aborder les notions de compilation et d'interprétation
- Savoir ce qu'est le langage machine
- Comprendre la différence entre typage statique et typage dynamique
- Comprendre la notion de mémoire vive d'un ordinateur
l'intérieur de la Matrice
As-tu déjà rêvé de faire un tour dans la Matrice, à l'intérieur même d'un circuit d'ordinateur, comprendre et réfléchir comme un ordinateur ?
Tu l'as rêvé, les studios de cinéma l'ont fait : est né le film Matrix où Néo (l'élu) rentre dans la Matrice pour supprimer un ver (virus se reproduisant).
La Matrice possède son mode de fonctionnement. Elle ne réfléchit pas comme nous. Et tu vas t'apercevoir qu'elle est plutôt surprenante !
Le langage machine
Ton ordinateur, aussi performant et puissant soit-il, ne comprend que deux valeurs : 0 et 1.
Comment se fait-il que mon ordinateur puisse faire tant de choses avec seulement 0 et 1 ?
Il existe des lois mathématiques qui permettent de transformer un nombre binaire en nombre décimal. En fait, il est possible de passer un nombre de n'importe quelle base vers une autre.
Tu te doutes bien, en considérant que l'ordinateur ne comprend que 0 et 1, que le langage de programmation que tu utilises n'est pas directement exécutable par ton système d'exploitation. Que tu écrives du Python, du C++, du PHP ou du C#, l'exécution du code écrit a besoin d'une étape intermédiaire pour exécuter le code que tu écris.
Cette étape intermédiaire transforme le code que tu as écrit en langage machine. Le langage machine est un langage que comprend directement ton système. Il est différent pour chaque architecture (32 ou 64 bits), processeur et système d'exploitation.
Par abus de langage, nous appelons le langage machine de l'assembleur. L'assembleur est un ensemble de mots mnémotechniques (add, sub, call, ret) qui aident le programmeur à coder en langage machine.
Puisque le langage machine est en réalité du binaire, nos cerveaux ont besoin du langage assembleur pour comprendre ce que nous écrivons. Interpréter des suites de 0 et de 1, c'est pas très fun et surtout très chronophage, comparé à l'utilisation de moyens mnémotechniques.
Mais au fait, c'est quoi l'étape intermédiaire entre le code et le langage machine ?
Lire "Les prérequis nécessaires" puis, si vous n'avez pas peur des maux de tête et des insomnies, lisez la suite
Compiler ou interpréter ?
Il existe deux méthodes pour transformer du code source lisible (C/C++, Python, C# ...).
La première est la compilation. La compilation produit un exécutable en langage machine, indépendant du code source. C'est une étape qui va lire tout le code source et le transformer une fois pour toutes en langage machine.
La méthode inverse à la compilation s'appelle l'interprétation. L'interprétation ne produit pas de fichier exécutable. L'interpréteur s'occupe de lire le code source et de le transformer à la volée en langage machine.
Alors quelle méthode est la meilleure : l'interprétation ou la compilation ?
Chacune des deux méthodes a ses avantages et ses inconvénients :
- La compilation :
Produit du langage machine une seule fois pour tout le programme. Fournit un exécutable. L'exécutable fourni est difficile à comprendre et à modifier. Cependant, il est possible de lui apporter des optimisations bas-niveau.Les compilations de gros projets peuvent être longues.L'exécutable fourni ne s'exécute bien souvent que dans un seul environnement.
- L'interprétation:
Produit du langage machine expression par expression pendant l'exécution du code. Ne fournit pas d'exécutable, mais exécute directement le code source. L'exécution est plus lente car le code est transformé à la volée.Produit du code portable.Plus facile à écrire et déboguer, dû à la nature dynamique d'un langage interprété
Et ça change quelque chose à ma manière de coder ?
Oui, beaucoup. En général, les langages compilés sont beaucoup plus stricts que leurs homologues interprétés où plus de liberté est permise.
Exercices non obligatoires.
À regarder jusqu'au bout.
Une variable
Sais-tu ce qu'est une variable ? Une variable est, comme son nom l'indique : variable. Sa valeur peut évoluer au cours du temps. En informatique, une variable est un nom associé à une valeur pouvant évoluer dans le temps. A l'inverse d'une constante, qui est un nom associé à une valeur fixe pour toute la durée de l'exécution du programme.
Et donc, une variable est variable. Mais à quoi ça sert ?
Une variable est fondamentale car elle permet de stocker des informations pour les réutiliser plus tard. Elle met à disposition un nom bien clair qui permet de comprendre la donnée qu'elle stocke. Par exemple, ton nom d'utilisateur est stocké dans une variable qui réside quelque part dans la mémoire de l'ordinateur. Son nom pourrait être username.
C'est tout ? Une variable, c'est juste une valeur pouvant varier associée à un nom ?
Le typage statique ou dynamique
Une dernière chose ne t'a pas été expliquée sur la théorie des variables : une variable stocke une troisième information en plus de son nom et de la valeur qui lui est associée.
La variable stocke une valeur. Cette valeur peut être plusieurs choses : un nombre entier, une phrase, une date ... Eh bien, le type d'une variable détermine comment interpréter sa valeur. Ça peut te paraître un peu bizarre pour le moment, mais tu devrais comprendre pourquoi sous peu. Pas de stress !
C'est quoi, un type ?
Un type est un mot-clé représentant ce que la valeur stocke. La valeur stocke un type de données : un nombre entier, une suite de caractères, une date, une valeur booléenne (vrai/faux) ... Chaque type est représenté différemment en mémoire et, par conséquent, requiert un mécanisme différent pour lire sa valeur. C'est pour cela qu'une variable porte un type, pour que l'ordinateur sache comment interpréter sa valeur.
Et donc, c'est quoi le typage statique et dynamique ?
De même qu'il existe des langages de programmation compilés et interprétés, il existe deux façons de typer ses variables suivant les langages :
-
Le typage statique : aussi appelé langage fortement typé. Le langage typé statiquement déclare une fois pour toutes le type d'une variable. Il sera impossible, après la déclaration de la variable, de modifier son type. Il faudra créer une autre variable d'un autre type pour ce faire.
-
Le type dynamique : contrairement au typage statique, les langages à typage dynamique, aussi appelés faiblement typés, permettent plus de liberté que les langages fortement typés: les types des variables déclarées peuvent évoluer sans avoir à déclarer une variable d'un autre type.
Les langages fortement typés correspondent bien souvent aux langages compilés. Cela est dû à la nature statique de la compilation. À l'inverse, les langages faiblement typés correspondent bien souvent aux langages interprétés, car l'exécution est dynamique : les expressions sont évaluées puis transformées en langage machine à la volée, ce qui offre une plus grande liberté.
D'accord pour tout ça. Mais où sont donc stockées les variables ?
Lire les deux premiers paragraphes
La mémoire vive
Nous avons vu que les variables stockent des informations. Ces informations résident quelque part dans l'ordinateur. Et les variables résident dans la mémoire vive.
La mémoire vive: une sorte de mémoire vivante ?
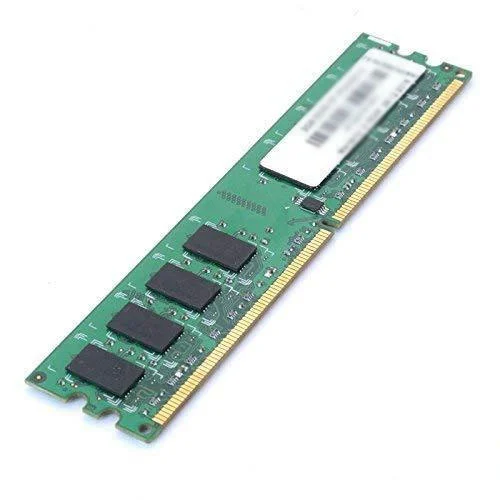
Oui, ça y ressemble. La mémoire vive est rapide et dynamique. Il s'agit d'électrons se déplaçant sur un circuit en silice. La mémoire vive est utilisée pour stocker un tas d'informations pendant l'exécution des programmes : allant de la couleur de la bordure de la fenêtre actuelle jusqu'aux phrases que tu es en train de lire. Quasiment tout ce qui est lié à l'environnement d'exécution d'un programme est stocké quelque part en mémoire vive. La mémoire vive est vidée à chaque redémarrage de l'ordinateur. Elle meurt.
La mémoire vive dans la machine est appelée RAM pour Random Access Memory.
Et s’il y a une mémoire vive, il y a une mémoire morte ?
Oui, effectivement, il existe une mémoire morte. Ou plutôt devrait-on dire "mort-vivante", car elle survit aux redémarrages de ton ordinateur. Les mémoires mortes sont tes disques durs. Au lieu d'être des électrons sur un circuit en silice, les informations sont stockées par des aimants ayant deux états : 1 ou 0. Par conséquent, la mémoire morte n'est pas vidée au redémarrage de l'ordinateur, car les aimants qui constituent la mémoire du disque dur ne bougent pas.
Mais alors, comment sont stockées les informations en mémoire ?
La représentation en mémoire vive
Nous rentrons dans le vif du sujet, car tu sais maintenant à quoi servent la mémoire et les deux types de mémoire que l'on rencontre sur les ordinateurs : vive et morte. Nous avons aussi vu que l'ordinateur ne comprend que 0 et 1. Avec ces deux chiffres, il est capable de réaliser toutes les opérations. La mémoire n'échappe pas à la règle et elle ne stocke que des suites de ces deux valeurs 0 et 1. On appelle ces valeurs les bits.
Un ordinateur comprend uniquement la base (arithmétique) binaire.
La base arithmétique binaire, c'est-à-dire le terme fumeux pour désigner un nombre fait de 0 et de 1 ?
Oui, exactement. Des opérations mathématiques régissent les bases arithmétiques. Il y a autant de bases arithmétiques que de chiffres, de lettres et de symboles. Les bases qui nous intéressent nous, informaticiens, sont principalement les bases binaires et hexadécimales. S’il y a bien deux représentations à connaître, ce sont celles-ci.
Hexadécimal ?
Hexa signifie six, décimal signifie dix. La base hexadécimale est par conséquent composée de 16 symboles : 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, A, B, C, D, E, F.
Lorsque tu analyses la mémoire, il s'agit de la représentation utilisée. Si tu veux aller plus loin dans la compréhension du fonctionnement des ordinateurs, la maîtrise du passage hexadécimal/binaire/décimal est recommandée, pour ne pas dire essentielle.
Mais alors, pourquoi utilise t-on le système hexadécimal et pas le système décimal ?
La conversion entre binaire et décimal est beaucoup plus compliquée que la conversion hexadécimal<->binaire.
Un seul symbole hexadécimal est codé sur quatre bits. C'est-à-dire que le symbole ayant la valeur la plus élevée : F, vaut 1111. Partant de ce principe, il est beaucoup plus simple de faire la conversion hexadécimale<->binaire.
Lire introduction et partie "Conversion" pour comprendre le passage hexa<->binaire.
Lire introduction et plus si tu veux.
Les unités de mesure de la mémoire
Nous avons abordé la notion de bits. Un bit est un chiffre binaire : 0 ou 1. Comme tu le sais déjà, on transforme rapidement une suite de quatre bits en chiffre hexadécimal. Il existe une unité de mesure de la grandeur de la mémoire. Cette unité permet de quantifier de la mémoire de la même manière que des grammes ou des litres : il s'agit de l'octet.
Un octet est une suite de 8 bits. Il s'agit donc de deux fois quatre bits. Un octet se représente donc très facilement en hexadécimal : il s'agit de deux symboles hexadécimaux. L'octet est plus avantageux pour la représentation de la mémoire occupée, car il est plus grand qu'un bit et donc produit des chiffres moins impressionnants, par exemple 1 Mo = 1 000 000 octets = 8 000 000 bits, ce qui fait beaucoup.
Lorsque l'on parle d'architecture matérielle "grand public", on parle toujours d'octets. Il s'agit de la plus petite unité après le bit. Ainsi, 4 ko, c'est-à-dire quatre kilo-octets, font 4 * 1 000 * 1 octets, soit 4 000 octets, ce qui équivaut à 4 000 * 8 bits, soit 32 000 bits.

Un deuxième ordre de grandeur existe. Il est assez simple en somme : 1 Ko = 1024 * 1 octet.
Challenge
Un peu d'arithmétique et de culture
Transforme:
-
1111 0000 1111 0000, qui est en base binaire, en base 16 -
1F0qui est en base hexadécimale, en base binaire -
010qui est en base binaire, en base hexadécimale
Je veux aussi que tu dresses une liste de trois langages interprétés et de trois langages compilés en complément des calculs.
Critères de validation
-
Trois langages interprétés sont présents dans la réponse
-
Trois langages compilés sont présents dans la réponse
-
La première conversion est juste
-
La deuxième conversion est juste
-
La troisième conversion est juste